容器网络 netkit 方案:替代 veth 吞吐和延迟追平主机,实现作者论文深度解读
本文地址:https://www.ebpf.top/post/netkit-container-packet-delivery-ebpf
这篇解读完全基于论文 Netkit: Specializing Linux Packet Delivery for Container Networks,论文已被 eBPF'26 Workshop 收录。两位作者 Daniel Borkmann 和 Paul Chaignon 都来自 Isovalent at Cisco,也就是 Cilium 背后的公司(见本号《第 3 起 BPF 圈收购:Cisco 计划收购 Cilium 母公司 Isovalent(附前 2 起)》)。netkit 也是 Borkmann 提交进内核的,文中数据都是作者在自家方案上测的。文中图片均直接截自论文,图号与论文一致。
1. 背景:backlog 队列在协议栈的哪里
先看论文图 1。Linux 收包时,驱动在下,协议栈上半部分(tc、netfilter 与 IP、TCP、socket)在上。中间那段锯齿线就是每个 CPU 的 backlog 队列:驱动把包放进目标 CPU 的队列,稍后再由上半部分处理。右侧标出了几个常用的 BPF 钩子:驱动层的 XDP、tc 层的 tc-bpf、socket 层的 sockmap。
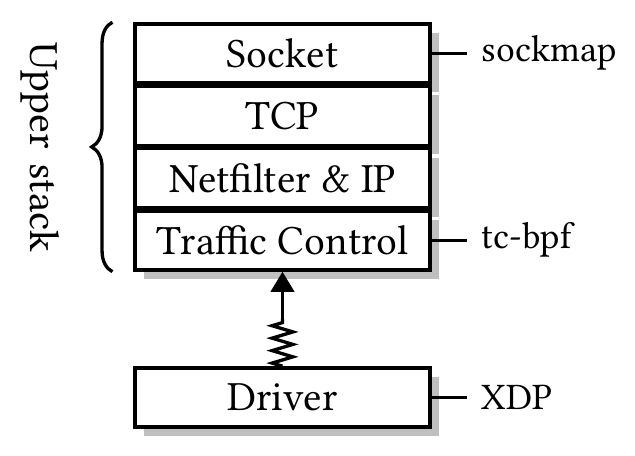
图 1:Linux 收包路径与主要 BPF 钩子,锯齿线表示经过 backlog 队列(图源:Borkmann & Chaignon, arXiv 2609.18633, Figure 1(CC BY-NC-ND 4.0))
物理网卡收到的包通常不走 backlog 队列(除非开了 RPS)。容器网络的插件大多挂在上半部分,用 netfilter 或 tc-bpf 实现策略和转发。
2. 问题:veth 让包多排了一次队
容器靠网络命名空间互相隔离。命名空间只是逻辑边界,包跨过去并不需要拷贝数据,按理不该有开销。
但连接容器和主机的 veth 设备会模仿物理网卡的行为:包从 veth 一端发出,另一端收到时要先放进每个 CPU 的 backlog 队列,再交给协议栈。论文图 2 画出了三条路径,锯齿线就是排队的位置:
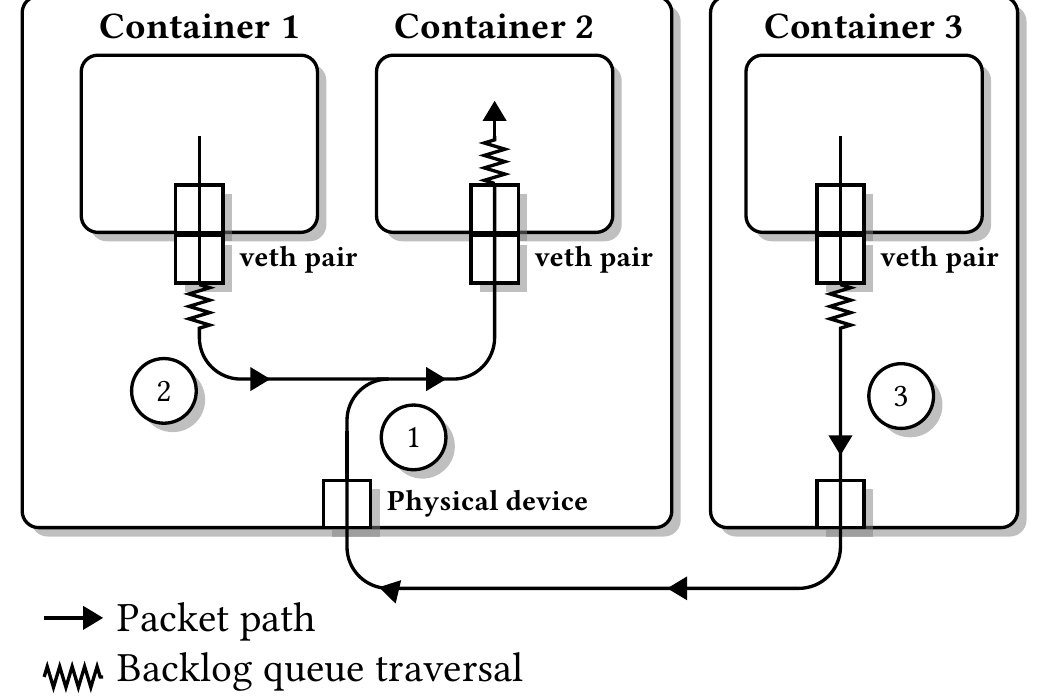
图 2:使用 veth 设备对时容器之间的收发路径,锯齿线表示经过 backlog 队列(图源:Borkmann & Chaignon, arXiv 2609.18633, Figure 2(CC BY-NC-ND 4.0))
逐条看:
- 路径 ①,网线进容器:包从物理网卡进来,在主机协议栈里路由后交给主机侧 veth,再到达容器侧 veth。容器 2 上方的锯齿就是这一次排队,发生在目标容器的收包侧。
- 路径 ②,同主机容器 1 到容器 2:包从容器 1 的 veth 出来,在主机侧 veth 的收包处排一次队(容器 1 下方的锯齿);转进容器 2 时又排一次(容器 2 上方的锯齿),一共两次。
- 路径 ③,容器 3 出网线:包从容器 3 出来,在主机侧 veth 的收包处排一次队,然后才走到物理网卡。
负载高时,这些排队的包还会交给 ksoftirqd 内核线程处理。它以普通优先级和其他任务抢 CPU,延迟因此上升;处理包的 CPU 时间也不再记在发包的进程头上。
开销有多大?作者在 3.1GHz Xeon 上用 netperf TCP_CRR(每秒新建短连接数)对比了有无命名空间的情况,结果见论文图 3:
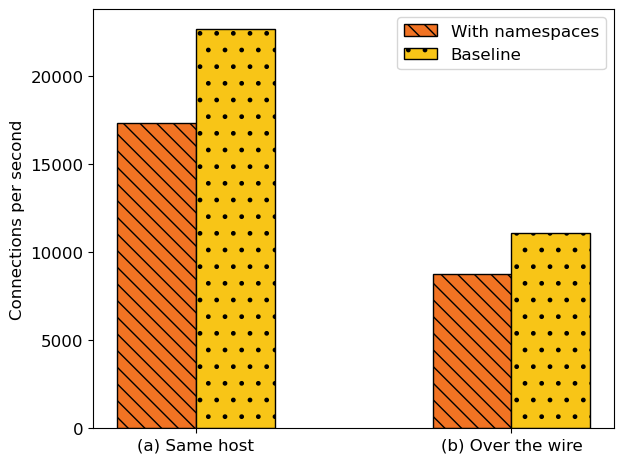
图 3:有无网络命名空间时的 TCP_CRR 每秒连接数,左为同主机,右为跨网线(图源:Borkmann & Chaignon, arXiv 2609.18633, Figure 3(CC BY-NC-ND 4.0))
去掉命名空间后,同主机快 31%,跨网线快 26%。这里的无命名空间同主机场景,是两个主机进程走 loopback 通信。
3. 两步改造:bpf_redirect_peer 去掉进容器那次,netkit 去掉出容器那次
论文图 4 是改造后的路径。和图 2 对比,多了虚线表示 BPF 重定向,锯齿只剩一处:
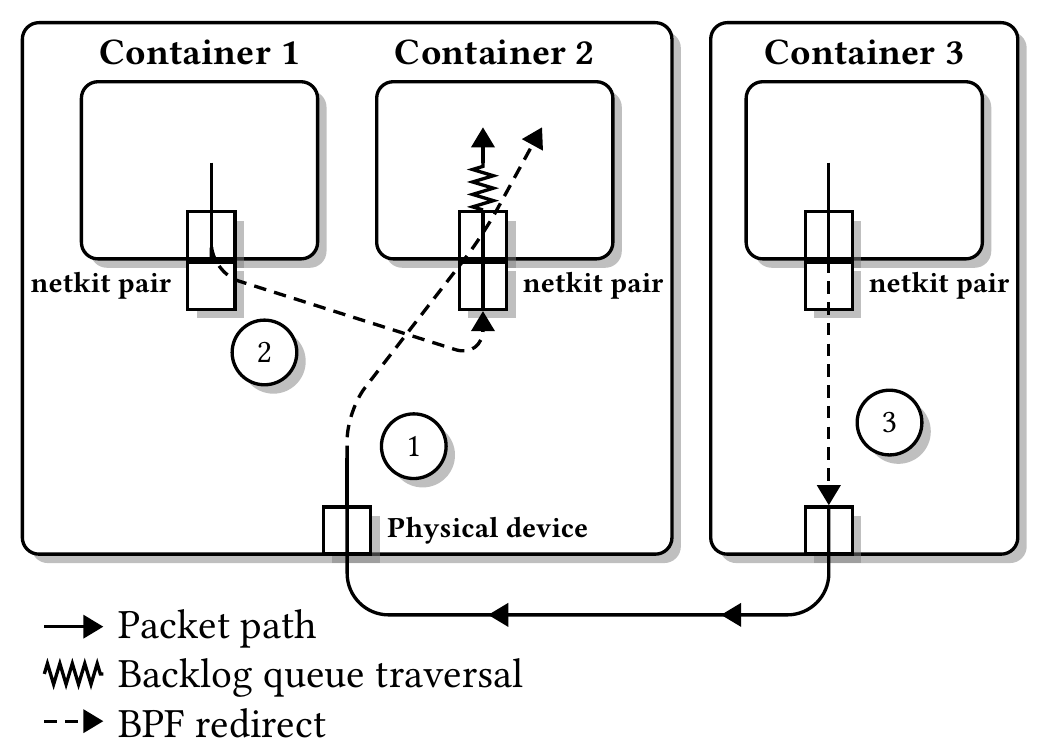
图 4:使用 BPF 重定向和 netkit 设备对后的容器收发路径,虚线表示 BPF 重定向(图源:Borkmann & Chaignon, arXiv 2609.18633, Figure 4(CC BY-NC-ND 4.0))
第一步,路径 ① 用 bpf_redirect_peer。 作者注意到,物理网卡收包后执行的上半部分协议栈,和容器内 veth 排完队之后执行的代码在功能上是同一套,只是所在命名空间不同。于是加了 BPF helper bpf_redirect_peer(Linux 5.10 合入):在主机侧的 tc-bpf 钩子里调用它,把包切换到目标容器的命名空间,直接在容器的协议栈上半部分继续处理。这样省掉了两件事:主机侧 veth 的发送路径,以及容器侧的那次排队。图 4 中路径 ① 的虚线从物理网卡附近直接指进容器 2,没有锯齿。
它放在 tc 层而不是 XDP,是因为 XDP 在 GRO 之前,处理的是一个个未聚合的小包,要重定向很多次;放在 tc 层可以对 GRO 聚合后的大包(包括超过 64KB 的 BIG TCP)只做一次。
第二步,路径 ③ 和 ② 用 netkit 设备对。 出容器那次排队在主机侧 veth 的收包处。要避开它,得在容器侧设备上就把包送走,但在容器命名空间里装 BPF 程序有三个问题:可能和应用自己的 BPF 程序冲突;应用能把它卸掉,绕过安全策略或断网;而且它看不到主机的路由表。
作者因此新造了一种设备对 netkit(Linux 6.7 合入)来替代 veth,和 veth 有几点不同:
- BPF 程序直接挂在设备上,不用配置 tc qdisc 和过滤器。程序在设备发送路径上、命名空间切换之后执行,所以挂在容器侧设备上的程序跑在主机命名空间里,能查主机路由。
- 两端不对等:主机侧是主设备,容器侧是对端设备。只有主机侧的控制面(如 Cilium)能通过主设备管理程序,容器里的应用挂不上也卸不掉。没挂程序时可以默认丢包,控制面就绪前不会漏流量。
- 默认三层模式,省掉 veth 需要的邻居解析;需要以太网语义的容器也可以配成二层模式。
- 不支持 XDP。
有了 netkit,路径 ③ 用普通的 BPF redirect helper 就能把包从容器的 netkit 设备直接送到物理网卡(图 4 中容器 3 向下的虚线),不需要新 helper,因为程序本来就在命名空间切换之后执行。包没进队列,处理一直留在发包进程的上下文里,CPU 时间记账正确,也不会交给 ksoftirqd。
路径 ② 也一样:从源容器的主机侧 netkit 设备,直接重定向到目标容器的主机侧 netkit 设备(图 4 中从容器 1 到容器 2 的虚线),省掉源端那次排队。
剩下的一次。 图 4 里还剩一处锯齿:同主机两个容器通信时,目标容器收包侧那一次。包从一个命名空间的发送路径转到另一个命名空间的接收路径,至少要排一次队,不大改协议栈就省不掉。作者也可以把这次排队留在源端,但选择留在目标端,这样挂载点统一是 netkit,不用混用 netkit 和 tc-bpf。想彻底去掉,只能用 sockmap 绕过协议栈,那又要求应用不需要完整的协议栈。
也就是说:路径 ① 和 ③ 都不再排队;路径 ② 从两次排队降到一次。
代码改动不大:内核侧新 helper 78 行,netkit 设备 1,048 行(不少是 BPF link、netlink、内核模块的样板代码);Cilium 侧分别改了 49 行和 463 行。
4. 效果与前提:追平进程间通信,但主机不能依赖 netfilter
测试用两节点 Kubernetes 集群,Linux 6.8 加 Cilium v1.19.5,硬件同前。基线是同一套 Cilium 配置下用 veth。注意前提:Cilium 开了 kube-proxy 替换,各节点上的 kube-proxy 及其 netfilter 规则都已移除,策略、QoS、负载均衡都在 BPF 里做,因为重定向会绕过主机上的 netfilter 规则。
先看 TCP_RR(每秒请求响应事务数,间接反映延迟),论文图 5:
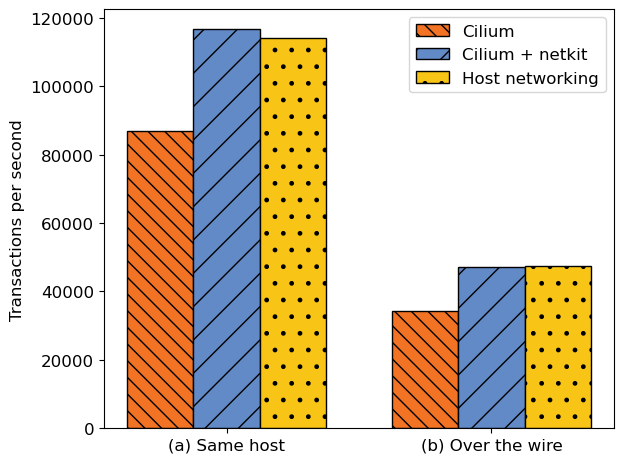
图 5:TCP_RR 每秒事务数,三组分别为 veth 下的 Cilium、Cilium 加 netkit、主机进程直连(图源:Borkmann & Chaignon, arXiv 2609.18633, Figure 5(CC BY-NC-ND 4.0))
再看 TCP_CRR(每秒新建连接数,更接近大量短连接的业务),论文图 6:
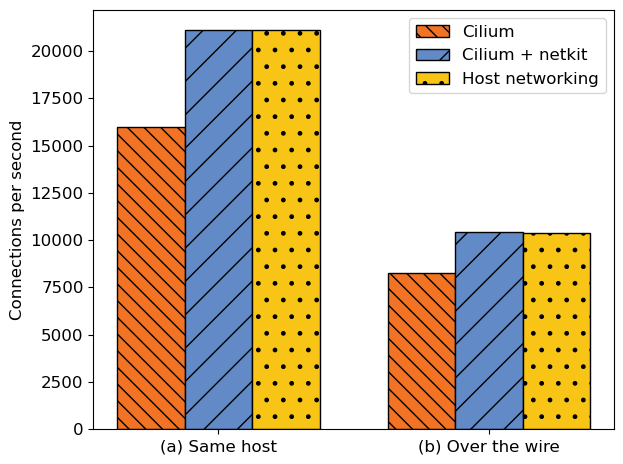
图 6:TCP_CRR 每秒连接数,分组同图 5(图源:Borkmann & Chaignon, arXiv 2609.18633, Figure 6(CC BY-NC-ND 4.0))
| 测试 | 指标 | 同节点 | 跨机 |
|---|---|---|---|
| TCP_RR | 每秒请求响应事务数 | +34% | +37% |
| TCP_CRR | 每秒新建连接数 | +32% | +26% |
这些是事务和建连速率,不是带宽吞吐。两张图里,Cilium 加 netkit 的柱子和主机进程直连基本一样高。论文的结论是,用上 netkit 后,容器通信和不用命名空间的主机进程通信达到同一水平,剩下的差别在误差范围内。
论文也比较了 AF_XDP、sockmap 和 ipvlan。前两者要求应用改用新接口,或者只覆盖部分场景;ipvlan 出方向不绕过主机协议栈,容器内的 BPF 程序也能被应用卸载,Cilium 社区因此移除了对它的支持。
5. 总结:命名空间只是逻辑边界,就别让包为它多排队
回到三条路径:bpf_redirect_peer 让路径 ① 进容器不再排队;netkit 设备对让路径 ③ 出容器不再排队,并把同主机的路径 ② 从两次排队降到一次。前提是容器数据路径已经全面换成 BPF,主机上不依赖 netfilter。
论文第 6 节称,netkit 已被 Meta 和字节跳动大规模部署在生产环境中。这是作者的说法,本文没有独立核实。想看 veth 场景的另一种加速思路,可以读本号的《基于 veth 场景 XDP 加速:出向流量转发性能提升约 10 倍》。
延伸阅读
- 原文作者:DavidDi
- 原文链接:https://www.ebpf.top/post/netkit-container-packet-delivery-ebpf/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。
- 最后更新时间:2026-10-19 19:24:00 +0800 CST