极限拉扯:10GB 内存 smoltcp 爆表跑到 1600 万个 Web 服务器!
本文地址:https://www.ebpf.top/post/15-million-webservers
10GB 内存、1 个 CPU 核心的虚拟机里,能同时放下多少个 Web 服务器?直觉上,墙可能是端口不够、进程太多,或者程序自己太重。
先看结论。 在《15 million webservers》中,一次单机实验给出的结果是:走内核协议栈时,一个空闲的套接字(socket)也要大约 3300 字节,大约 2.5M 个 Web 服务器就会把内存用光,而且每秒请求数(RPS)会随规模下降;换成用户态的 smoltcp 后,空闲大约 620 字节、活跃大约 1 千字节,规模跑到了 16M。同场对比里,DPDK(数据平面开发套件)最快,AF_XDP 紧随其后。
这组结果来自上述 10GB、1 核虚拟机上的单机测试,不能直接套到生产环境。要理解规模差距,我们先把内存账拆开,再看把协议栈搬出内核之后,DPDK 和 AF_XDP 各要付出什么代价。这里讨论的是 Artem Yarulin 已发表的实验记录,不是本机复现。
1. 目标很明确:10GB、1 核上放下 1500 万个监听中的服务器
先从一个最小的 Web 服务器看起:监听、接受连接、读取、回复 OK、关闭。在这次测试中,这样一个程序大约能跑到 65k RPS。但若真去启动 1500 万个进程,最先碰到的往往不是性能,而是地址不够用。
默认情况下,port=0 会让内核从 ip_local_port_range 里挑端口,测试环境里这个范围是 32768 到 60999。即便把范围放到 1-65535,端口号仍是 16 位整数,离 1500 万还差得很远。UDP 端口也不能直接用来增加 TCP Web 服务器的监听数量。若按每个 IP 约 3 万个端口粗算,1500 万个监听需要数百个 IP;增加 IP 并不要求一一增加网卡。
不过,增加监听地址不一定要增加网卡。每个监听中的服务器由 (protocol, IP, port) 标识,换一批 IP 就能换一批监听地址。Linux 的 AnyIP 可以在整段子网上监听。这里用到的是 IPv6 的本地路由。一条 /64 能提供约 1.8×10¹⁹ 个可监听地址。IPv4 同样能做,只是文章中对地址购买成本的估算高达约 2.5 亿美元。
地址的墙先被挪开了。可按新地址批量拉起进程,机器仍然报了内存耗尽。按这次实验的粗账,一个这样的服务器大约占用 1.5MB,1500 万个按十进制重算就要 22.5TB,远超 10GB 的预算。
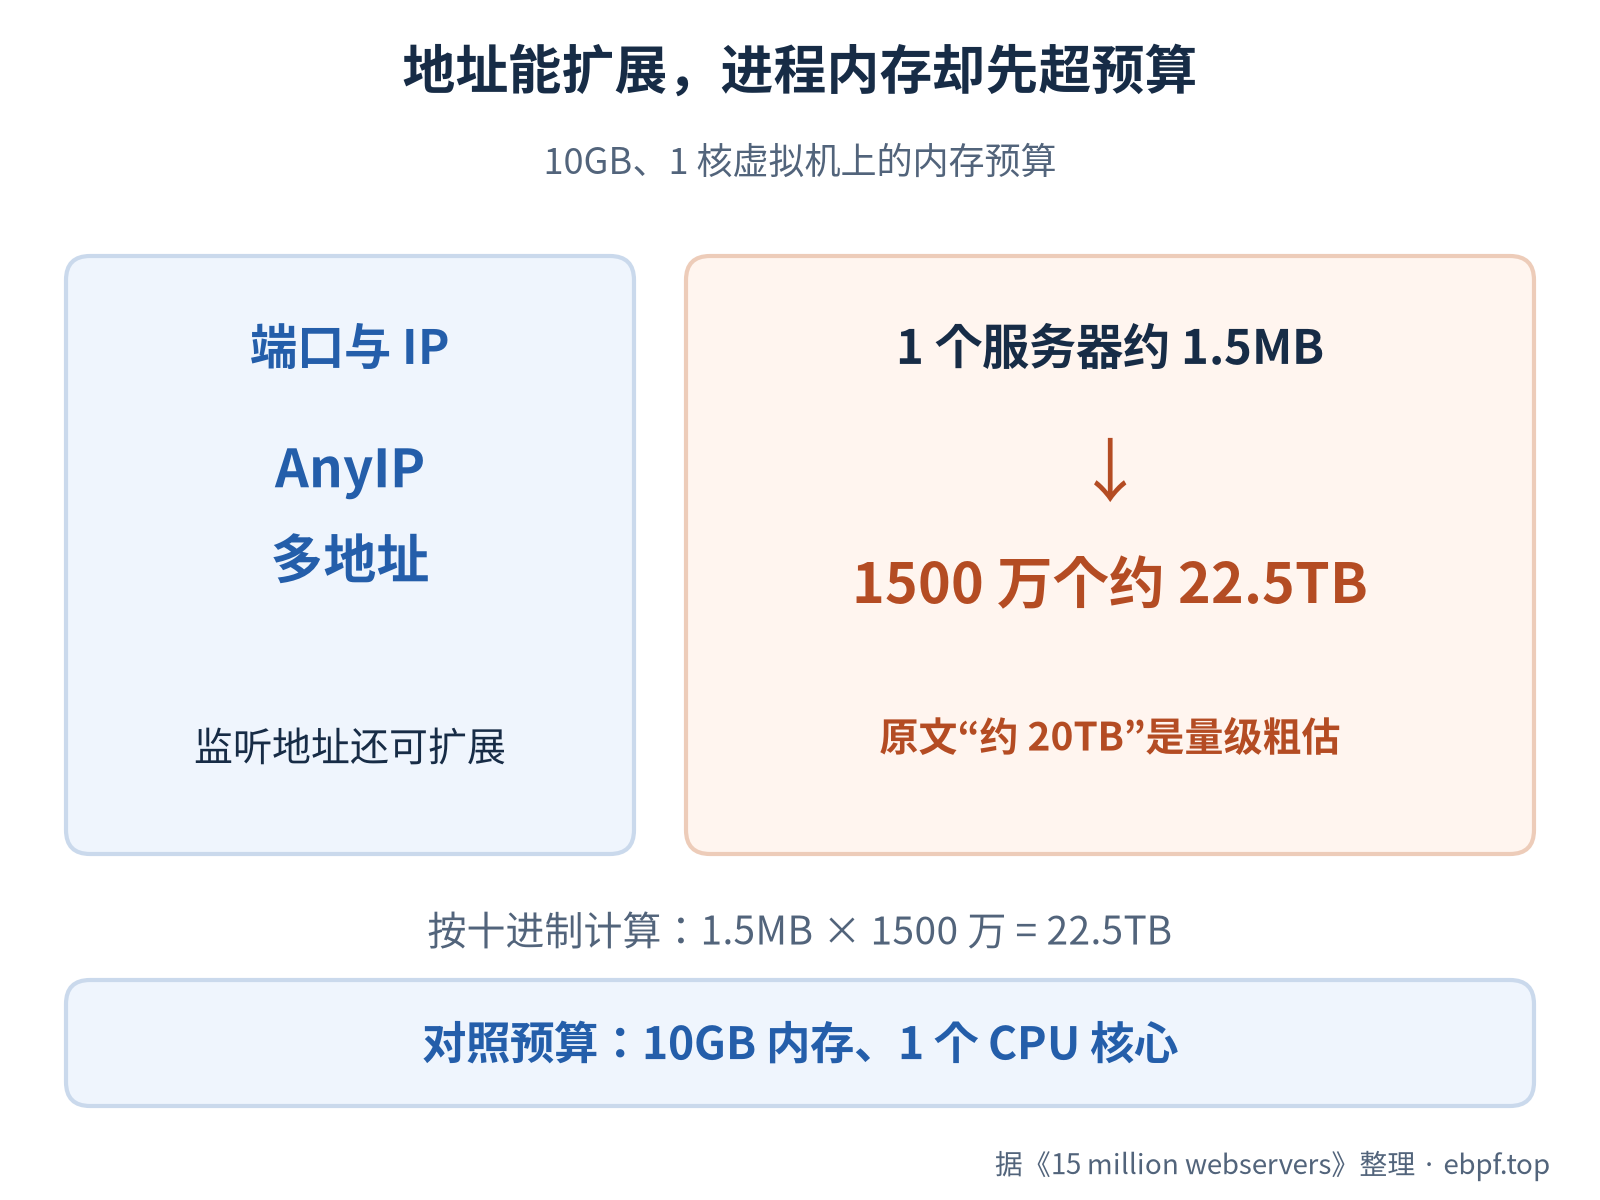
图1 端口和地址可以扩展,但进程内存已远超10GB预算。按每个1.5MB、1500万个以十进制重算约22.5TB;《15 million webservers》中的“约20TB”仅是量级粗估。
2. 先降低隔离和调度开销:一个进程里容纳大量 guest
地址够用了,但给每个服务器创建独立进程,仍会重复支付页表、内核栈和进程管理等固定成本。这次实验不是直接调小这些结构,而是沿着前两篇文章的路线,把大量 guest 放进同一个宿主进程:先解决隔离,再解决调度。
2.1 少建进程:用 LFI 隔离同一进程内的程序
在《一千万个 Codex CLI》中,起点是一个很紧的预算:100GB 内存容纳一千万个实例,每个只有约 10KB。测试先把程序缩成几乎只做阻塞等待,去掉标准库等依赖后,单个 Linux 进程仍消耗约 70KB。程序代码已经很小,进程本身的开销却不会跟着消失。
因此,隔离方式换成了轻量级故障隔离(Lightweight Fault Isolation,LFI)。程序重新编译时,内存访问和控制流受到约束,系统调用也被改写为进入宿主运行时,由它决定怎样处理。多个 guest 因而可以共处一个 Linux 进程,不必每个都对应一个独立进程;文件、网络等能力则要由运行时继续提供或转接。
不过,通用运行时自己的表、缓冲区和任务状态也占内存。实验进一步大幅裁剪功能,只保留获取编号、打印、阻塞等极少数调用,再顺序执行极简 guest。文中报告在 10GB 虚拟机里容纳了 12 亿个这样的沙箱,每个只保留 8 字节的运行时入口引用。这是特制玩具程序的极限演示,不是一千万个完整 Codex CLI 已经跑通,更不是完整应用只需 8 字节。 线程、文件系统、网络和系统调用兼容性仍需补齐。
2.2 不能只装进去:调度还得保存和恢复执行状态
程序装进同一个进程后,马上遇到下一个问题:如果某个 guest 一直计算、不主动交回执行权,其他 guest 怎么运行?《用户态 Linux 调度器》接着用 Rust 做了一个抢占式调度原型,通过定时信号打断当前任务,再返回运行时选择下一个。
关键不只是记住“执行到哪条指令”。原型最初只保存程序计数器,切回来后计算就出错了,因为另一个任务已经改动寄存器。补上寄存器和状态标志的保存、恢复后,示例才正常运行;一般程序还需要处理栈等更多上下文。隔离解决的是任务能访问什么,调度解决的是任务何时运行、暂停后怎样继续,二者不能互相替代。
自己调度也不自动更快。在文中五个纯计算任务的对比中,用户态版本约 304.84 秒,普通进程约 303.05 秒,反而略慢:宿主线程仍受 Linux 内核调度,定时信号的投递和返回也有成本。这不是 sched_ext 或替换 Linux 内核调度器。标题里的“负时间”则是运行时拦截取时调用、改变 guest 看到的时间,不是真实计算加速。这些结果都是特定原型的报告值,不是本机复现。
2.3 运行时轻了:内核 socket 的内存仍然要付
回到 Web 服务器实验,我们就能理解自定义运行时负责哪一层:用 LFI 做隔离,把系统调用交给运行时,再由调度器安排 guest 执行。并不是启动 1500 万个 Linux 进程,也不是照搬前篇演示里每个沙箱 8 字节的数字。
若假定切换只发生在主循环内部,每个 guest 要保存的最少状态,在这个简化模型里主要是程序计数器和两个文件描述符。按 16 字节计,1500 万个 guest 的调度状态是 240MB(十进制),约 229MiB。若再做位压缩,这个模型还有可能压到每个 8 字节。这里算的是特定切换点下的简化状态,不是任意时刻抢占通用程序所需的完整上下文,也不包含网络连接的全部内存。
真正容易误判的是连接本身。实验过程中,模型给出过一个颇具误导性的回答:空闲连接不占内存,活跃连接大约 5KB。若假定任意时刻只有 100 万个连接是活跃的,再加上 240MB 调度状态,好像只用掉 10GB 预算的一半。
验证很快把这张账单推翻了。只做 socket 加 listen、其余什么都不做,尝试拉起约 1400 万个空闲监听,结果仍然是内存耗尽。省掉独立进程,并没有省掉内核为每个 socket 保存的状态,接下来就得沿着网络这条线继续查账。
3. 空闲 socket 也要大约 3300 字节,内核路径大约 2.5M 就内存耗尽
漏掉的关键调用其实就在眼前:socket()。在这次测试里,这个系统调用会分配大约 3300 字节,不管套接字是在监听、正在传输,还是什么都不做。在 10GB 的虚拟机里,尝试执行 1000 万次 socket() 的循环会在完成前耗尽内存。
这些字节并不是一块整齐的接收缓冲区。文中还列出一份 AI 给出的结构体拆账,四项合计 3384 字节。下面只用它说明可能涉及的对象,并非本机核验的分配明细;具体大小随内核版本、配置和构建而变。
| 结构体 | 大小 | 主要用途 |
|---|---|---|
struct tcp_sock |
2240B | TCP 状态、队列、定时器、序号、拥塞控制与记账 |
struct socket_alloc |
768B | 带等待队列的 struct socket,以及 sockfs inode 与填充 |
struct file |
184B | 打开文件的操作、标志、凭证和引用 |
struct dentry |
192B | sockfs 上的目录项与生命周期记账 |
| 合计 | 3384B | AI 拆账的算术合计,非独立测量 |
这份拆账不能作为约 3300 字节报告值的精确证明。不过,按十进制 10GB 除以 1500 万粗算,每个服务器的预算只有约 667 字节,可取整为约 670 字节;报告中的空闲 socket 占用已经远超这个数。这里算的是容量预算,不是测量精度:基准图的 RAM 纵轴使用 GiB,不能与十进制 GB 混为一谈。
这也解释了后文基准里的那条边界:走内核协议栈时,大约 2.5M 个 Web 服务器就会把内存用光,而且 RPS 会随数量增加而下降。基准图上的标注是 Kernel network OOM at 2.55M,对应前面大约 2.5M 的规模边界。
若还想继续涨规模,就要换一条不在内核里为每个 socket 摊这么多状态的路。
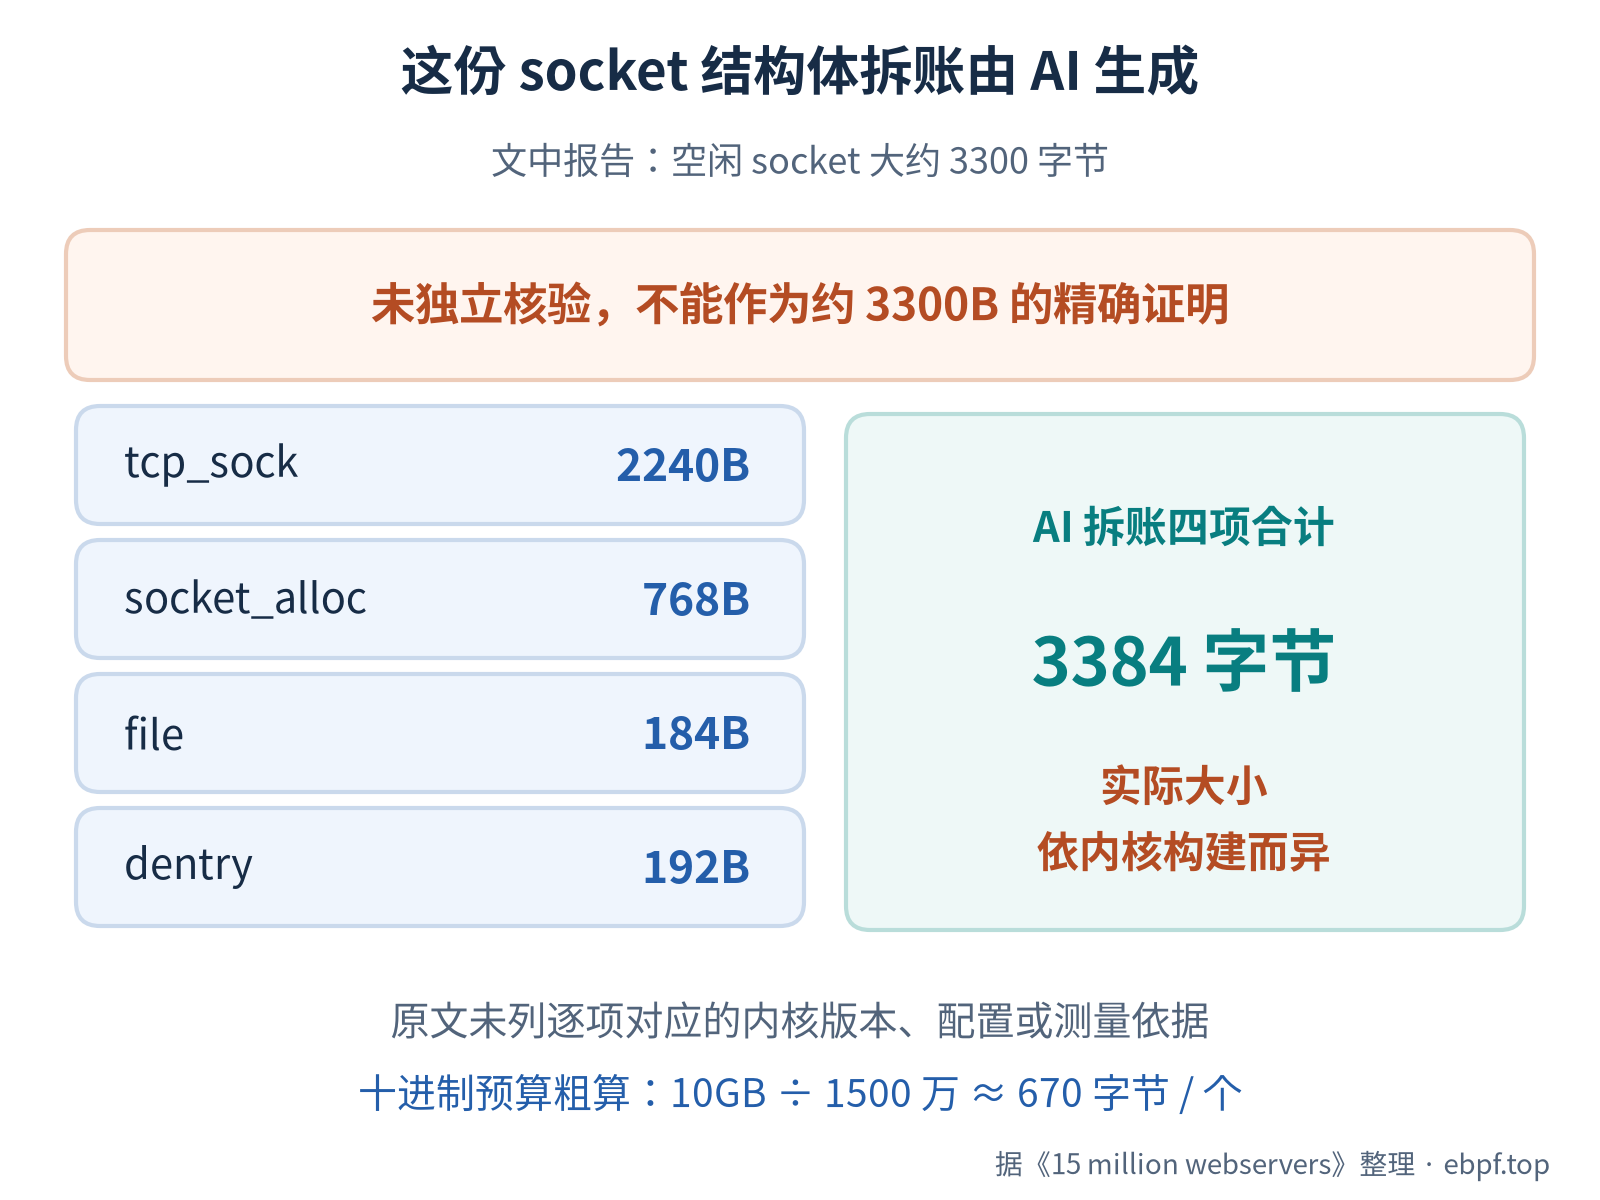
图2 《15 million webservers》中列出的一份AI生成的结构体拆账,四项算术合计3384B。该表未独立核验,不能作为约3300B的精确实测证明;实际对象大小依内核构建而异。约670字节是按十进制10GB除以1500万的预算粗算。
4. 把 TCP/IP 搬到用户态:smoltcp 负责解析,网卡通路还得另选
TCP 需要维护连接状态;在这个简化实现中,IP 包与以太网帧可以自行构造。只要自己实现传输层和网络层,应用就可以不再为每个连接向内核申请一份完整的 tcp_sock。嵌入式领域早就在做这件事。一个极端例子是 Adam Dunkels 的 Miniweb:它的无状态教育性概念验证只需约 24–28 字节 RAM,具体随指针大小而变,功能也作了显著取舍,不能当成通用 TCP/IP 栈的完整开销。更常见的实现还有 gVisor、Seastar、lwIP 和 F-Stack。
这次实验选择了 Rust 的 smoltcp。项目自己的说明是:
smoltcp 项目说明:
smoltcp is a standalone, event-driven TCP/IP stack that is designed for bare-metal, real-time systems. smoltcp does not need heap allocation at all
smoltcp 是一套独立的、事件驱动的 TCP/IP 协议栈,面向裸机和实时系统。它完全不需要堆分配。
但 smoltcp 本质上是一个聪明的解析器和状态机,它自己不做 I/O。要跟网卡打交道,可以接上三类通路:TUN 工作在 IP 层,TAP 再下一层、工作在以太网层,二者都由内核提供;DPDK 则让程序直接处理以太网帧,完全绕过内核协议栈。smoltcp 开箱就提供前两种。
为什么还要看第三种?文中用一组估算说明了延迟预算:一次系统调用本身可能要花 500ns,再把数据从内核拷到用户态可能还要 1000ns,具体取决于缓冲区大小。这两项只是用来说明量级的估算,不是这次 Web 服务器基准的测量结果,也不是所有网卡和内核路径的固定开销。
DPDK 的做法是让程序直接读写数据包缓冲区,不必再为每个包付一次系统调用。采用持续轮询收包的方式,也能减少密集收包时频繁中断对应用的干扰。但设备如何交给用户态,要看部署模式。采用解绑内核驱动、独占端口的 UIO/VFIO 等方式时,这个端口不再作为常规网络接口交给内核管理,原先经过它的 SSH 连接也会受到影响;忙轮询还可能持续占用 CPU。DPDK 官方文档也列出了与内核驱动共存的分叉驱动(bifurcated driver)模式,可以按流分给内核与 DPDK,不能把独占网卡当作 DPDK 的必然属性。上述单机实验记录没有明确给出所用驱动模式,不能据此反推。
5. 同场对比里 DPDK 最快,AF_XDP 紧随其后
现在还有第四条路。Linux 的 AF_XDP 可以把选中的流量交给用户态处理,内核仍管理网络设备。eBPF 过滤器可以决定把包重定向到用户态缓冲区,还是交给常规协议栈;只要正确配置分流,让 SSH 等管理流量继续走常规路径,就能保留这条管理通道。
内存映射本身不保证零拷贝。AF_XDP 内核文档明确区分 copy 与 zero-copy 模式:网卡驱动支持并启用相应模式时才可使用零拷贝,否则可能回退到拷贝模式。SO_PREFER_BUSY_POLL 配合忙轮询及相应配置,可能以更多 CPU 消耗换取更少中断,但并非一个开关就能保证永久无中断或固定占满一核。在这次基准里,DPDK 最快,AF_XDP 紧随其后;这只是该场测试的排序,不代表只有 AF_XDP 能保留管理面。
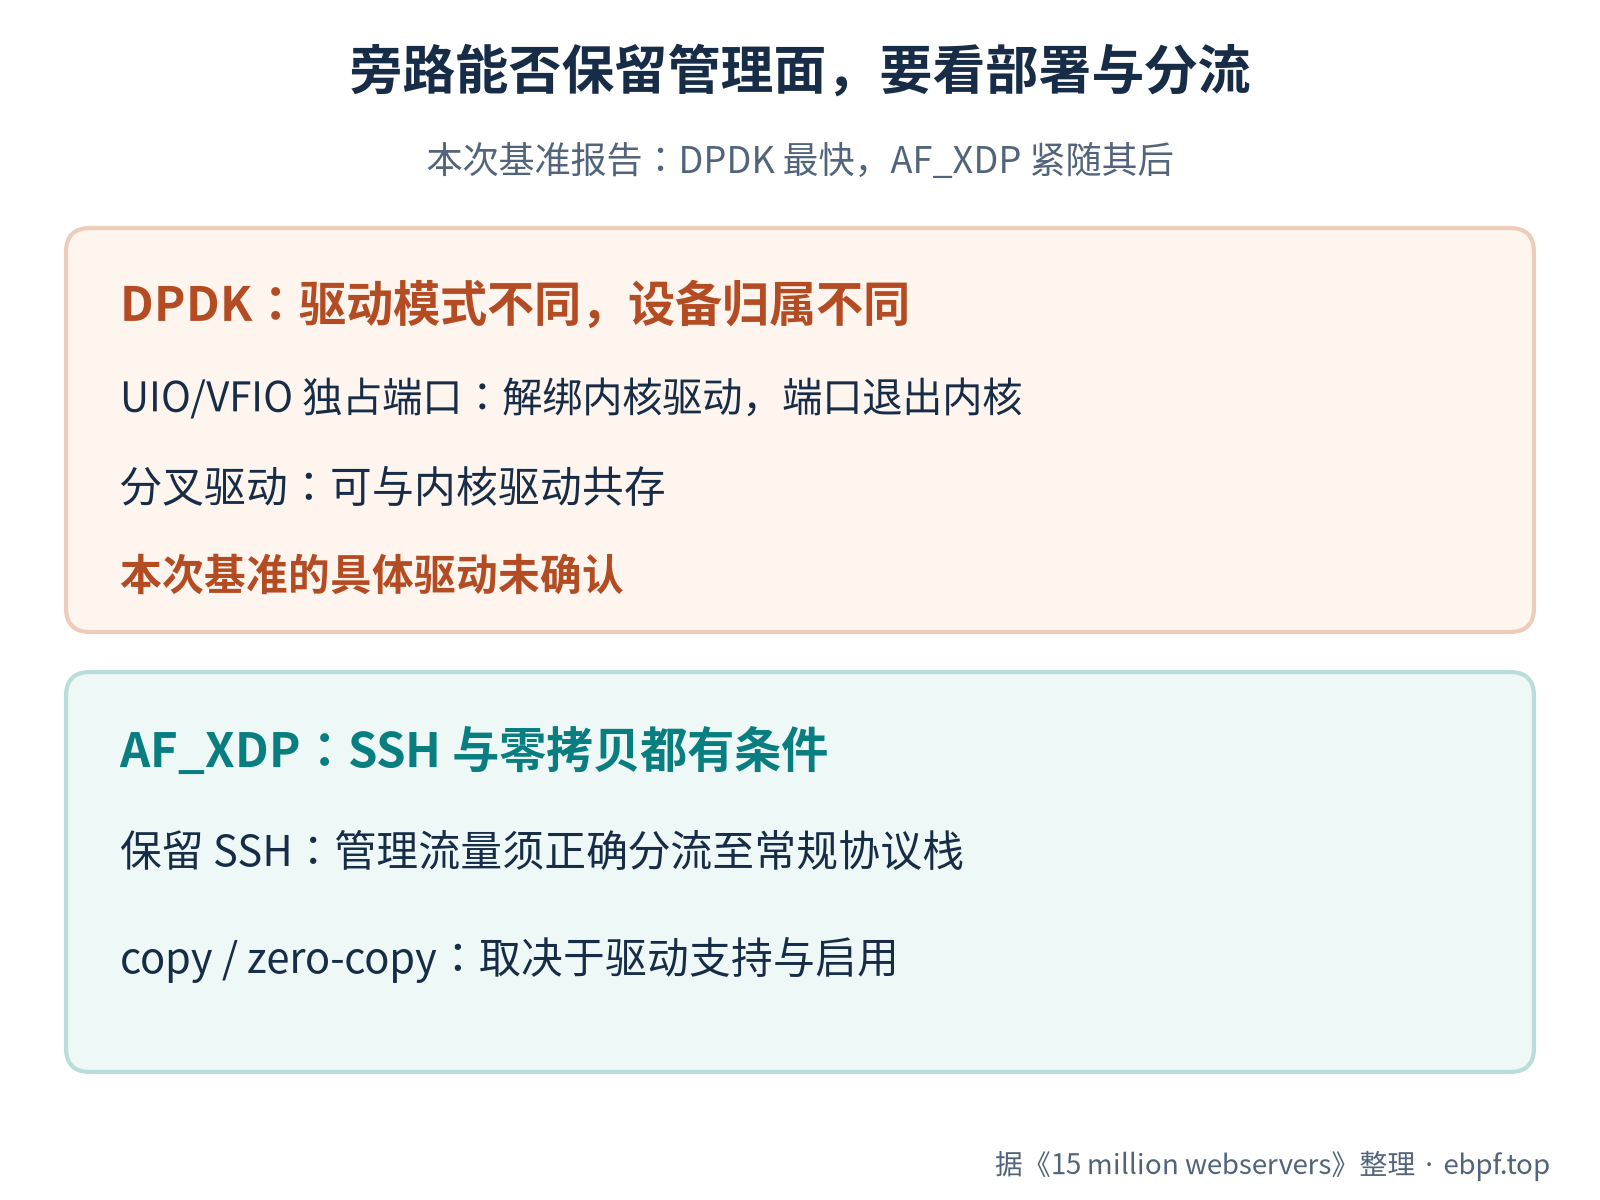
图3 DPDK的设备归属取决于驱动部署模式:解绑内核驱动、独占端口的UIO/VFIO方式与可共存的分叉驱动不同,本次基准具体驱动未确认。AF_XDP保留SSH需要将管理流量正确分流至常规协议栈,copy/zero-copy取决于驱动支持及模式启用;性能排序仅为本次基准报告结果。
把 XDP 放到更早的路径上,并不自动等于在所有场景都更省 CPU。这一点可以对照已发的《XDP 更早掉包不等于更省 CPU》。若关心容器网卡上的 XDP 转发,也可以看《基于 veth 场景 XDP 加速》。内核协议栈里时间耗在哪,则可以对照《数据包到底卡在哪?用 netstacklat 给网络协议栈做 CT》。
要让 smoltcp 接上 DPDK 或 AF_XDP,可以实现带 3 个方法的 Device trait;也可以借助现成 crate,例如处理 DPDK 的 rust-dpdk-net,以及处理 AF_XDP 的 xsk-rs。
拼起来的最终流程是:运行时把 1500 万个 Web 服务器 guest 载入同一进程;调度器轮流执行它们;guest 的系统调用被拦截,替换成 smoltcp 及其网卡适配器;每个 guest 用自己的地址监听;调度器从适配器轮询数据,唤醒对应 guest,处理后再切到下一个。
沿这条路径跑下去,单机基准的差距就显现出来了:内核协议栈在大约 2.5M 个 Web 服务器时把内存用光,而且 RPS 随数量增加下降;用了 smoltcp 之后,内存增长更慢,空闲大约 620 字节、活跃大约 1 千字节,规模跑到了 16M。在这次对比里,DPDK 最快,AF_XDP 紧随其后。基准图还包含 TUN 和 TAP,但文章中没有单独列出二者的精确结果。
| 路径 | 本次单机基准结果 | 需要记住的代价 |
|---|---|---|
| 内核协议栈 | 约 2.5M 时内存耗尽(图标注 2.55M),RPS 随规模下降 | 空闲 socket 也要大约 3300 字节 |
| smoltcp | 空闲约 620 字节,活跃约 1KB,跑到 16M | 本身不做 I/O,要接 TUN、TAP、DPDK 或 AF_XDP |
| DPDK | 同场对比中最快 | UIO/VFIO 独占端口模式会解绑原内核驱动;也有共存的分叉驱动模式,忙轮询消耗 CPU |
| AF_XDP | 紧随 DPDK | 零拷贝依赖驱动与模式;管理流量须正确分流,忙轮询消耗 CPU |
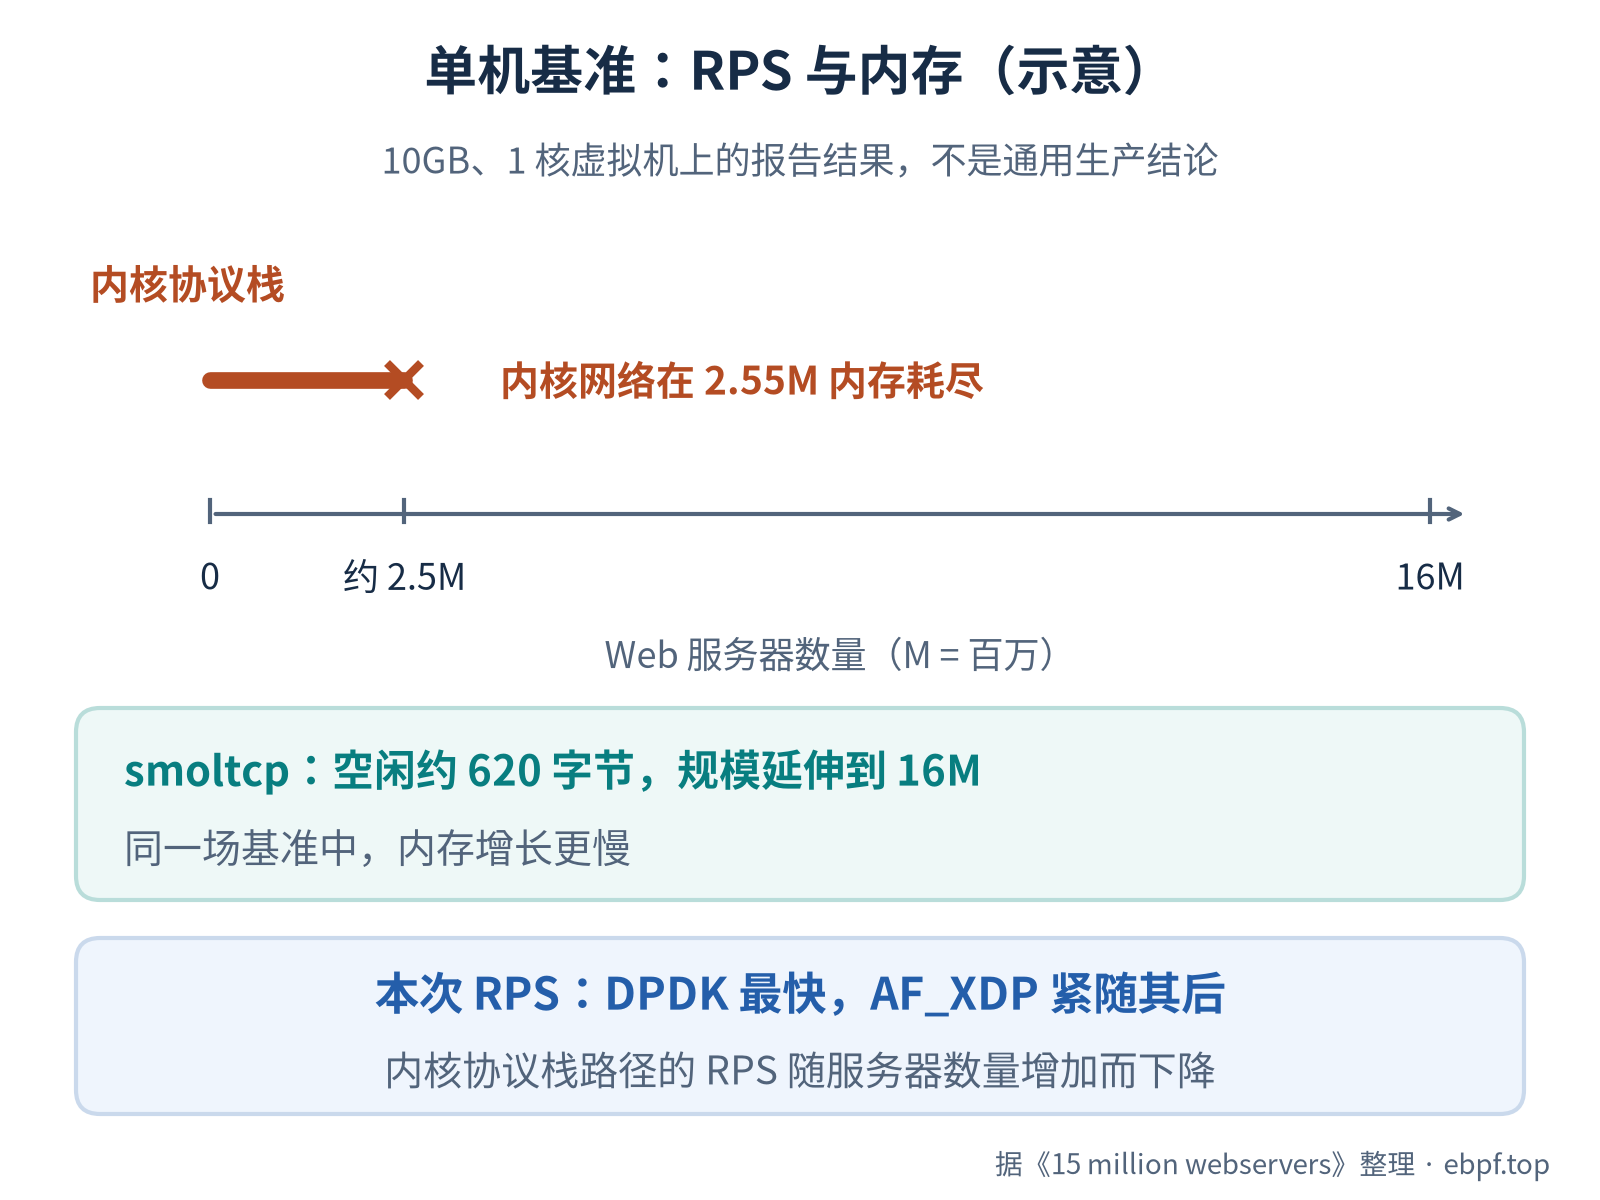
图4 《15 million webservers》中10GB、1核虚拟机上的单机基准示意,依据文中结论重绘,不是描点复制,也不是通用生产结论。
6. 总结:先看清内存账,再谈绕过内核协议栈
这场实验真正有用的,不是 1500 万这个口号,而是这张内存账:内核里一个空闲 socket 已经要大约 3300 字节;把协议栈搬到用户态之后,空闲占用才降到大约 620 字节,并在同一台 10GB、1 核的虚拟机上跑到 16M。这次基准里 DPDK 最快,AF_XDP 紧随其后;实际选路还要看驱动模式、零拷贝支持和管理流量的分流配置,而不是简单地在“独占网卡”和“保留 SSH”之间二选一。
这些结果只适用于上述单机实验,换机器、换网卡、换负载,都需要重新测量。概念验证的源码在 AI10M 的 ten-million-webservers 目录。不过,概念验证跑通,不等于一套兼容的 Linux 运行时已经完成。把系统调用按 POSIX 兼容性重新实现,仍是后续要解决的问题。
延伸阅读
- 原文作者:DavidDi
- 原文链接:https://www.ebpf.top/post/15-million-webservers/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。
- 最后更新时间:2026-11-21 09:43:01.984325641 +0000 UTC