循环更好验证,调用和栈更宽松:Linux 7.4 的 BPF 更新
本文地址:https://www.ebpf.top/post/linux-7-4-bpf-feature-overview
1. 先看结论:循环验证、调用与栈是核心变化
这轮 BPF 更新的核心,是让更复杂的程序更容易通过验证、组织调用并安排栈空间,而不是让所有 BPF 程序运行得更快。主要变化先看下面五项;数字来自维护者的合并说明,不是本号实测。
| 能力 | 合并说明中的支持范围 | 阅读时要注意 |
|---|---|---|
| 标量演化分析 (SCEV) | 验证器能力,未限定单一架构 | 降低的是带循环程序的验证工作量,不是运行速度 |
callx 间接调用 |
x86-64、arm64、riscv64 | 只能调用静态子程序,不是任意地址执行 |
unwind_goto / unwind_exit |
x86-64、arm64 | 不等于完整 Rust 或 C++ 运行时已就绪 |
| 2 KiB 栈、不超过 16 字节按值传参 | x86-64、arm64 | 不是全架构同步放宽,也不是取消栈预算 |
| 内联函数 BTF | 依赖 CONFIG_DEBUG_INFO_BTF_INLINE |
不是升级后自动具备,也不等于所有内联点都可探测 |
观测、网络与安全还有配套更新:内联函数信息进入 BTF、TCP 可借助控制组上的 struct_ops 扩展,签名与内存安全检查也在补强。下文再逐项解释它们解决什么问题、有哪些使用边界。
2. 7.4 还在候选,先看验证器怎样接住更复杂的程序
Linux 7.4 还没有正式发布。截至 2026-11-16(北京时间),kernel.org 上的主线版本是 7.4-rc3,稳定版仍是 7.3.4。面向 7.4 的 BPF 更新已经进入 Linus 的主线仓库,但这不等于发行版已经带上这些能力,也不等于后续候选版本不会再改细节。
本号在《Linux 7.3 BPF新特性:binfmt_misc 可编程、arena 指针直通 kfunc、验证器"说人话"》文末写过:把栈从 512 字节提到 2 KiB,以及异常清理,当时还在路上。这两项现在已经出现在 7.4 的 BPF 合并请求里。
本文依据的是 10 月 22 日北京时间,Alexei Starovoitov 提交的面向 7.4 的 BPF 合并请求。10 月 24 日北京时间,内核的拉取跟踪机器人确认,标签 bpf-next-7.4 已进入 torvalds/linux.git,对应这次合并提交。官方 lore 可能有反爬,这里使用可读镜像作为同一封邮件的文本来源。
对写 BPF 的人来说,这次更新要回答的问题很具体:程序里的循环、函数组织和栈空间都比以前更复杂,验证器怎样在不放松安全边界的前提下把它们接住?下面按循环验证、间接调用、栈与传参、异常清理这条线展开,观测、TCP 与安全只作为补充。后文数字均来自这份维护者说明,不是本号实测。本文只整理这次首轮合并请求,不是最终发布说明;候选期间的后续修复,以及尚未确认进入 7.4 的改动,不计入这份概览。
3. 循环不必再逐轮走完:SCEV 降低的是验证工作量
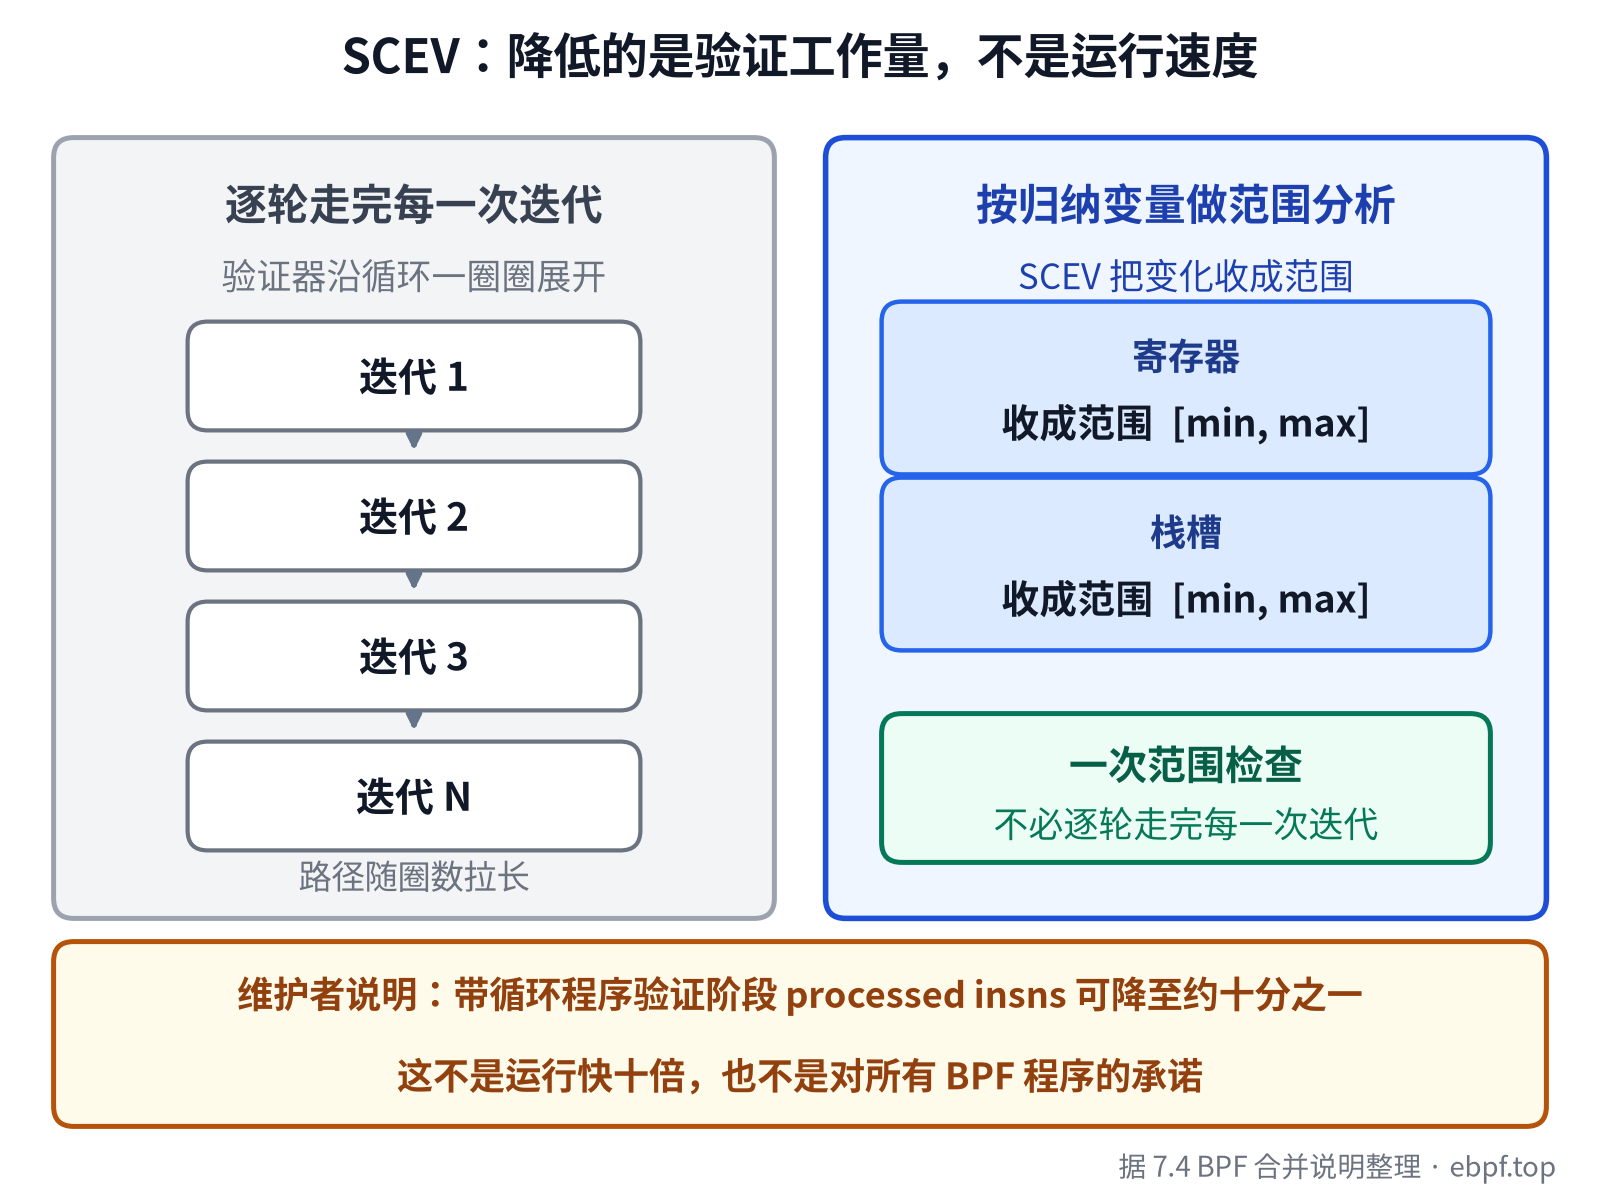
带循环的 BPF 程序一直不好过验证器。过去常见做法是,验证器沿着循环把迭代一圈圈走完,再判断边界和安全性。循环次数一多,或者归纳变量变化方式稍复杂,验证成本就会很快抬升。本号此前写过《eBPF 进阶:5种循环方式你都掌握了吗?》,讨论的是循环该怎么写;7.4 这边变化的,是验证器怎样分析这些循环。
Eduard Zingerman 为验证器引入了标量演化分析 (SCEV, scalar evolution)。按合并说明的说法,它会推断循环中寄存器和栈槽如何变化,让验证器把带归纳变量的有界循环当成范围来检查,而不必逐轮走完每一次迭代。
Alexei Starovoitov(维护者说明):
The number of processed insns drops ten fold in programs with loops
在带循环的程序中,处理过的指令数量降至原来的十分之一
这句话里的 processed insns,指的是验证阶段处理过的指令数量,不是程序跑起来快了十倍。它也不是对所有 BPF 程序的承诺,口径限定在带循环的程序。本号没有独立复现这个数字,因此只作为维护者说明来引用。
对开发者的直接意义是:以前可能因为验证路径过长而难以通过的循环逻辑,现在有了按范围判断的路径。它没有取消循环必须有界这一前提,也没有改写程序在内核里的执行方式。
据 7.4 BPF 合并说明整理 · ebpf.top
4. 函数可以间接调用,但目标必须是静态子程序
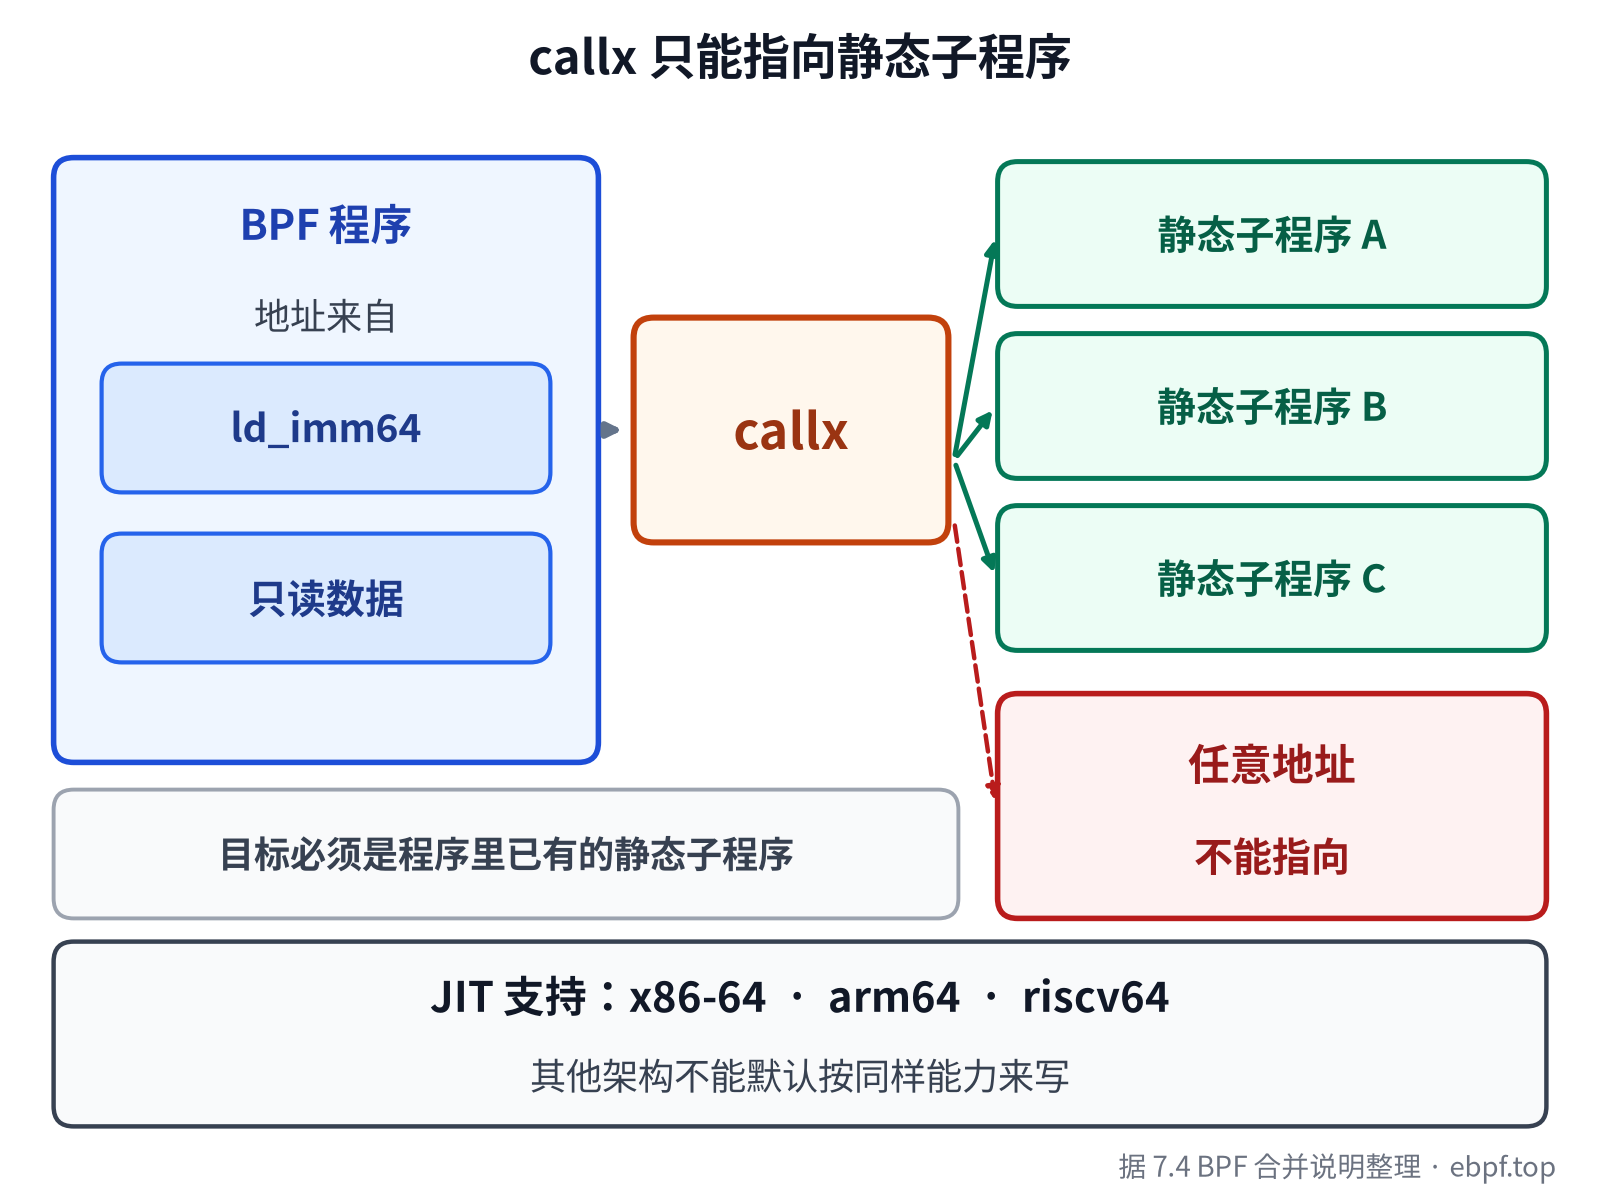
程序复杂之后,不只是循环变多,函数组织也会变。过去 BPF 子程序更多依赖直接调用;7.4 增加了 callx 指令,用来间接调用静态 BPF 子程序。合并说明写得很明确:地址来自 ld_imm64,或从只读数据中加载。作者是 Alexei Starovoitov 和 Pu Lehui。
这不是任意地址执行。可以被 callx 找到的,仍然是已经在程序里的静态子程序,而不是运行时拼出来的任意代码位置。JIT 支持范围是 x86-64、arm64 和 riscv64,其他架构不能默认按同样能力来写。
如果要在这些架构上用函数指针组织 BPF 子程序,callx 提供的是一条受验证器约束的路径,而不是把 BPF 变成普通用户态动态调用。
据 7.4 BPF 合并说明整理 · ebpf.top
5. 栈从 512 字节到 2 KiB,传参也可以带上更大的值
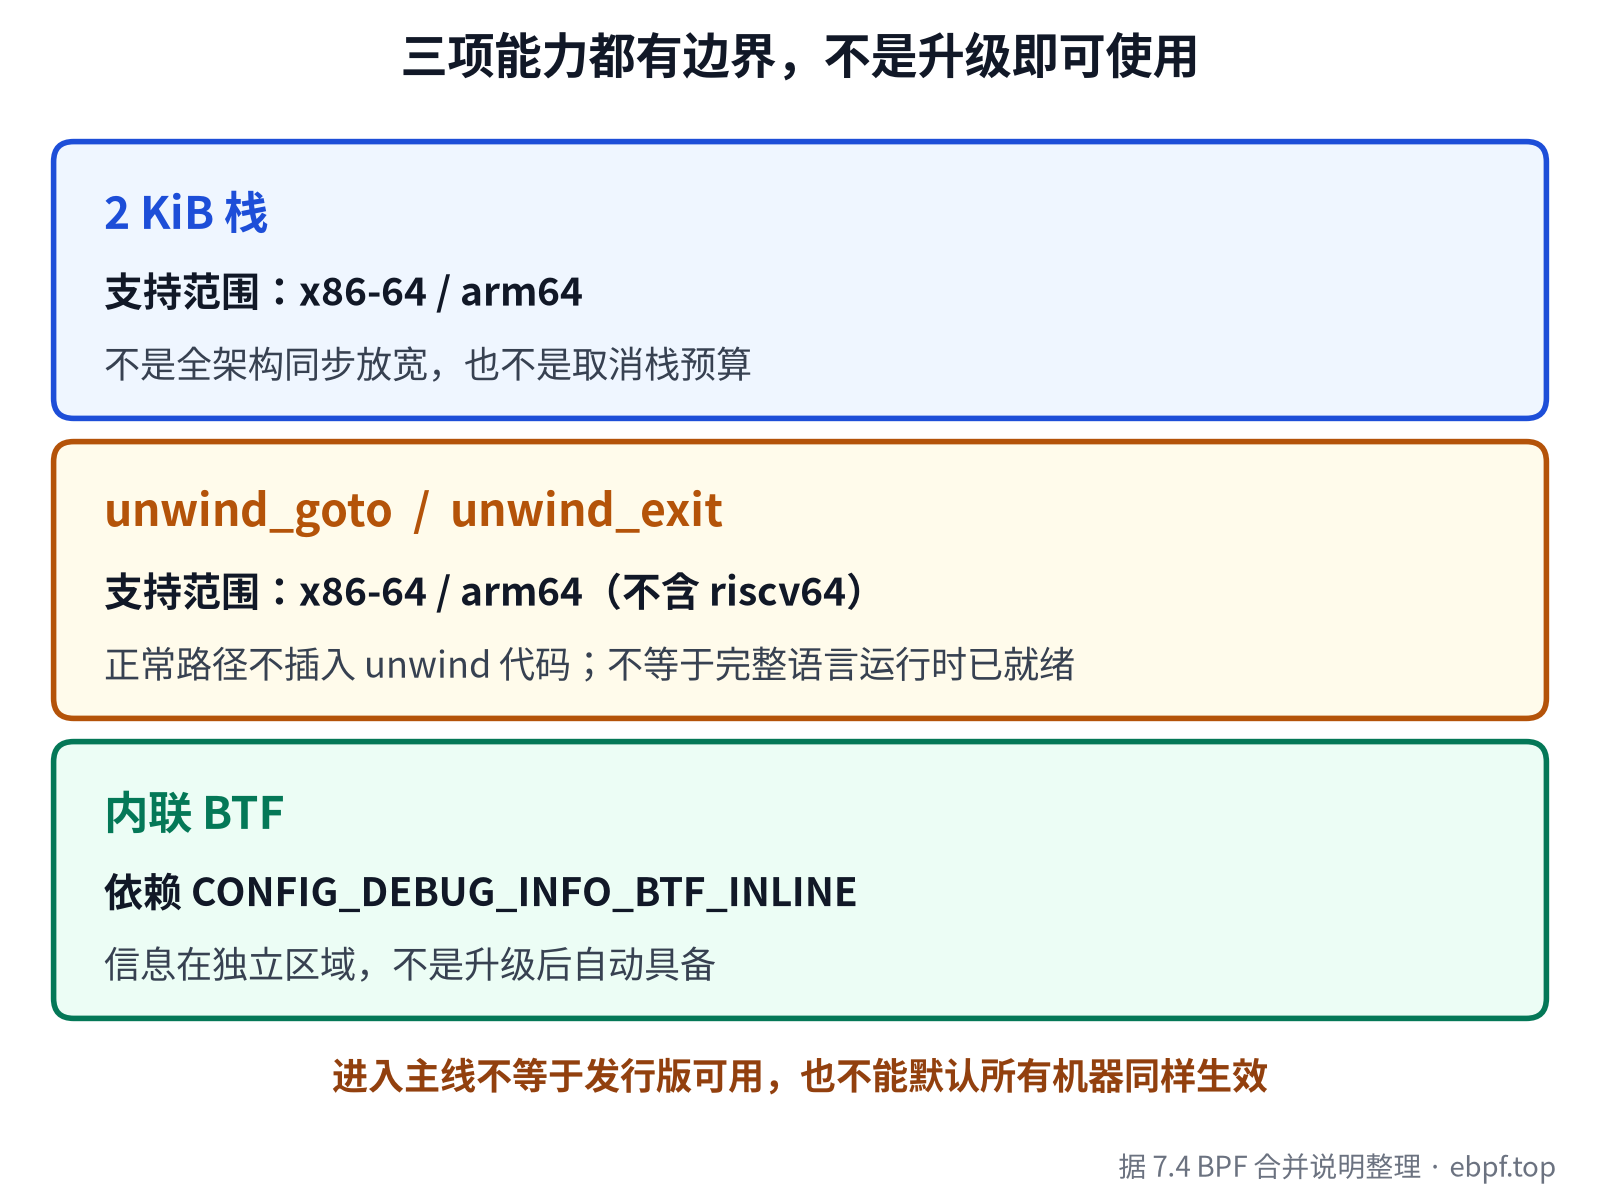
栈空间是另一条长期限制。Kumar Kartikeya Dwivedi 把 BPF 程序栈从 512 字节提高到 2 KiB,但合并说明只写了 x86-64 和 arm64。不是所有架构同步放宽,也不是取消栈预算。
与此同时,Yonghong Song 让 BPF 子程序和内核函数 (kfunc) 可以按值传递和返回不超过 16 字节的结构体、联合体和 __int128,并修正了 x86-64 与 arm64 的跳板 (trampoline),以支持这类参数。16 字节是上限,不是结构体可以任意变大。
对开发者来说,这两项往往一起起作用:栈更宽,一些原先只能拆开存放的小结构,现在可以按值传递;但移植到其他架构时,仍要按各架构实际支持来检查,不能默认 2 KiB 栈和 16 字节按值传参已经全局生效。
6. 异常清理已经有指令,但不等于完整语言运行时已就绪
7.3 文末提到还在路上的异常清理,在 7.4 里对应的是 unwind_goto 和 unwind_exit。Alexei Starovoitov 在合并说明里写,它们是为了让 Rust 的 panic 或 C++ 异常在穿过的每一帧上运行析构函数;正常路径不会插入 unwind 代码。所列 JIT 支持是 x86-64 和 arm64,范围比 callx 更窄,不包括 riscv64。
同一份说明还提到,rust-bpf 编译出的程序会得到更多支持:通过数字进行的加载和存储,可在 BPF_F_ARENA_SCALAR 下按 arena 访问处理,BPF 类型格式 (BTF) 也开始接受 Rust 名称。这些是编译和验证侧的进展,不等于任意 Rust 或 C++ 程序现在都能直接作为 BPF 运行。更完整的语言路径,本号已在《用 Rust 写 BPF 还差什么:LPC 2026 Alexei rust-bpf 进展解读》里讨论过,这里不再展开。
7. 观测、TCP 与工程补强:先看边界再看能力
除了验证器和程序组织,7.4 还有几项值得先记住边界的能力。
观测方面,Alan Maguire 把内联函数的信息写进了 BTF。新的种类用来说明内联点在哪里、参数该怎么取;这些信息由 CONFIG_DEBUG_INFO_BTF_INLINE 单独管理,放在 .BTF.inline 段,或 btf_vmlinux_inline.ko 里,并不并入主 BTF。它不是内核升级后自动具备的能力,也不是所有被内联的函数都会自动获得可探测点。机制细节见本号已发表的《fentry 挂不上?内核近 4 成函数被内联,BTF 正在补上这块盲区》。
网络方面,Martin KaFai Lau 和 Amery Hung 引入了通过 bpf_link 把结构操作程序 (struct_ops) 挂到控制组 (cgroup) 的通用做法。首个使用者是 bpf_tcp_ops,它镜像了 TCP 的 sock_ops 回调。Kuniyuki Iwashima 还增加了 enqueue_rcvq 和 dequeue_rcvq 钩子,用来调整 sk_rcvlowat,减少不必要的唤醒。这是给 TCP 可编程控制补了一条挂载路径,不是一份新的拥塞算法实现。
安全与工程侧,只点到边界。Daniel Borkmann 增加了用于程序签名校验的 .bpf 密钥环,设计上参考 dm-verity 的密钥环,并在签名工具中支持 ML-DSA。David Windsor 和 Daniel Borkmann 还提供了 bpf_inode_init_xattr(),让 BPF LSM 可以在 inode 创建时设置扩展属性;这项能力的归属争论,本号已在《BPF 作者 Alexei 硬刚 LSM 维护者 Paul:一个 kfunc 的归属,得大 Boss Linus 拍板》写过,这里不重开讨论。Alexis Lothoré 为 x86-64 上即时编译 (JIT) 后的程序内存访问增加了内核地址消毒器 (KASAN) 检查,范围同样只写了这一架构。
性能数字也要按原口径来读。Mykyta Yatsenko 加快了 u32 和 u64 键的哈希查找;T.J. Mercier 的说明是,哈希表每个元素的内存占用最多可减少 50%。这不是所有映射 (map) 类型,更不是整机内存减半。Jiri Olsa 还加快了 x86 上 tracing_multi 的挂载。此外,Daniel Borkmann 把 lib/test_bpf.c 里合并说明所称的 16k 行指令测试,迁到了 BPF 自测试 (selftests),由 BPF 持续集成在其覆盖的架构上运行。Josef Bacik 和 Alexei Starovoitov 也修复了核心、验证器、迭代器、本地存储、dynptr、devmap、cpumap 和 seg6local 中的多处内存安全、生命周期和锁问题。这些改动很重要,但不是这次阅读的主线。
据 7.4 BPF 合并说明整理 · ebpf.top
延伸阅读
- 原文作者:DavidDi
- 原文链接:https://www.ebpf.top/post/linux-7-4-bpf-feature-overview/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。
- 最后更新时间:2026-11-20 07:16:01.095813878 +0000 UTC