跨区域流量被打满,HRT 用 eBPF 揪出元凶
本文地址:https://www.ebpf.top/post/hrt-ebpf-wan-attribution
Hudson River Trading(HRT)的工程师 Eric Goldlust 在 2026 年 10 月 12 日发布的 Long on Research, Short on Bandwidth 里,复盘了一次跨站点带宽被打满的排查。HRT 的研究算力分布在全球多个站点,程序常常远离它要读的数据,WAN 带宽因此成了硬约束。问题在于:链路被打满时,他们很难说清是哪个用户、哪个工作流造成的。
最终方案分三层:用 eBPF 在内核 TCP 收发函数上按进程统计字节;针对 NFS 让流量归属失真的问题,改到 NFS 底层函数做请求与传输的关联;再把 eBPF、服务日志和交换机计数三方对账,保证每个字节只算一次。下面按排查的顺序展开。
1. 问题:服务日志能解释的流量,不是全部流量
事情从一次训练变慢开始。一个程序要用芝加哥的 GPU 分析纽约的数据,跨站拷贝走的是 HRT 内部的专用传输服务 DupeDog。某天拷贝明显变慢,监控显示传输速率骤降。
第一反应是有别人在抢带宽。但把所有 DupeDog 用户的曲线画出来,故障时刻并没有新用户出现,所有人的传输是一起变慢的。再看交换机的原始入向计数,链路已被一股来源不明的流量打满,而这股流量不属于 DupeDog。加上另一个服务,分布式文件缓存 Cashy,也不是它。
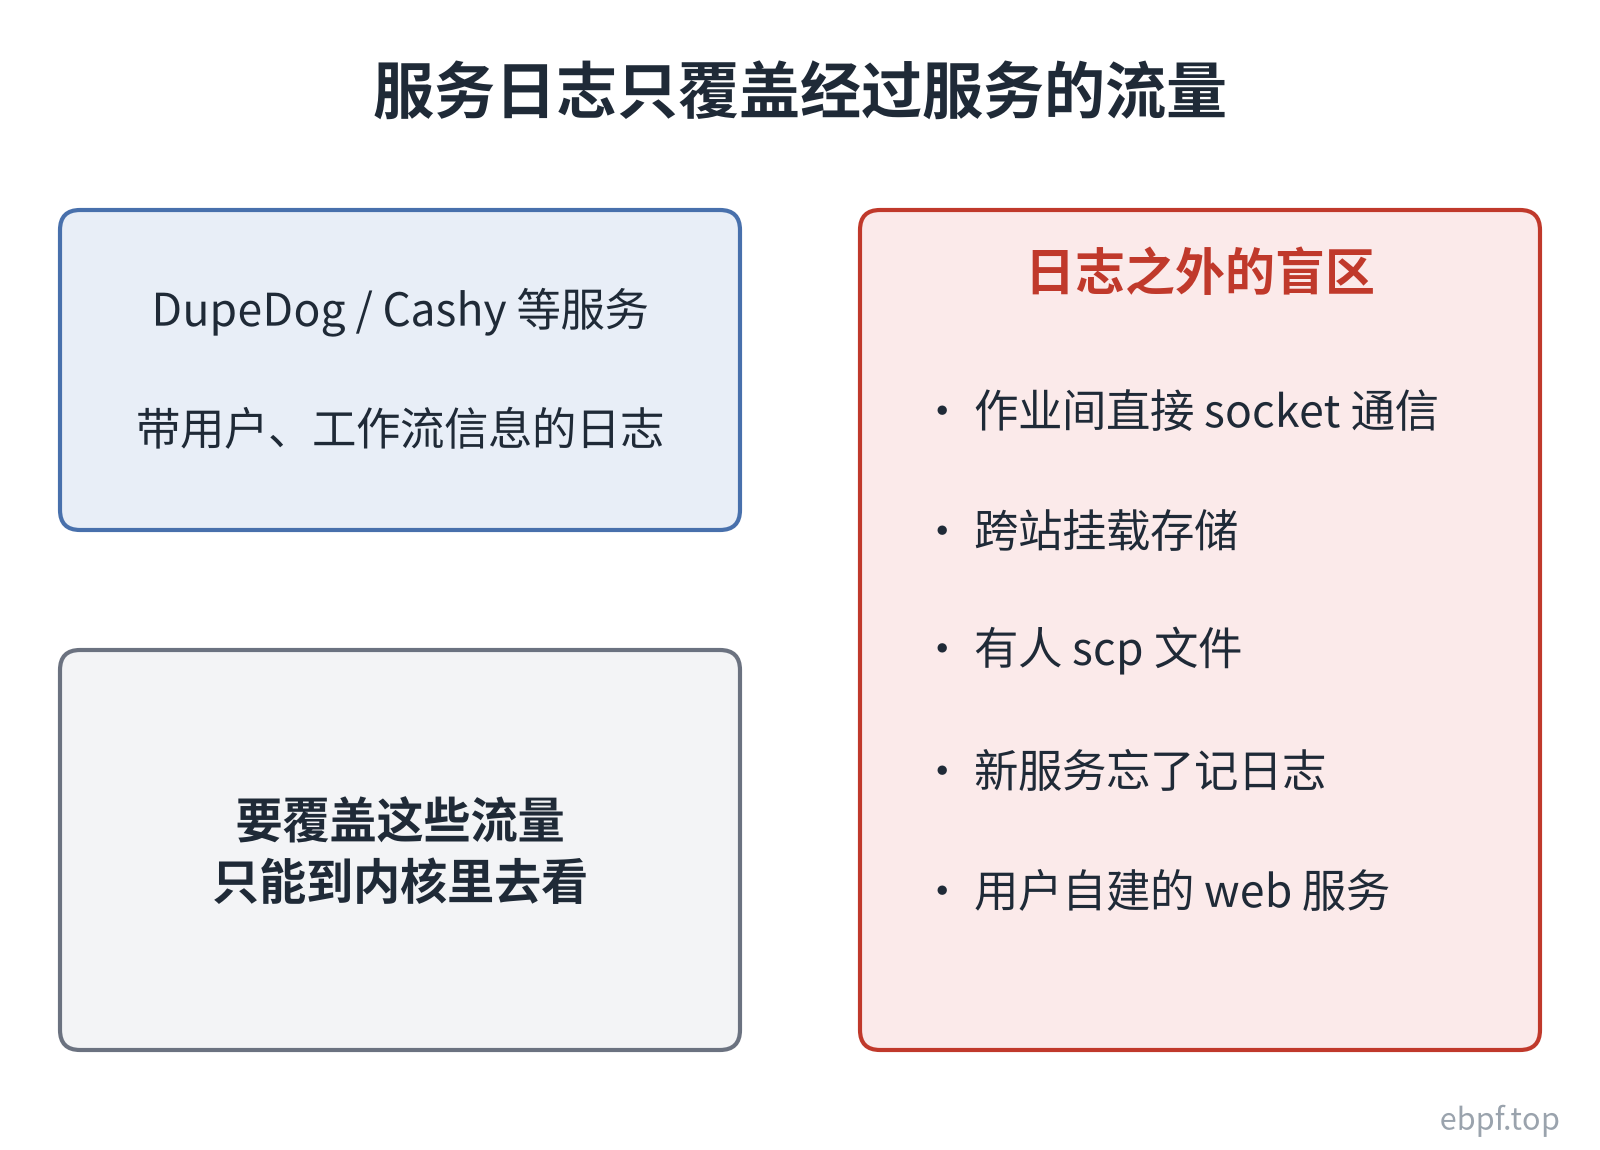
原因不难理解。HRT 给研究员很大自由,可以自选工具、自建工作流,作者也承认让 100% 的 WAN 流量都走同一个服务并不现实。DupeDog、Cashy 这类服务能记录带用户和工作流信息的日志,但只覆盖经过它们的流量。作业之间直接用 socket 通信、跨站挂载存储、有人 scp 文件、新服务忘了记日志、用户自建的 web 服务,都在日志之外。要覆盖这些流量,只能到内核里去看。
2. 原理:大多数 TCP 收发最终都会经过 tcp_recvmsg 和 tcp_sendmsg
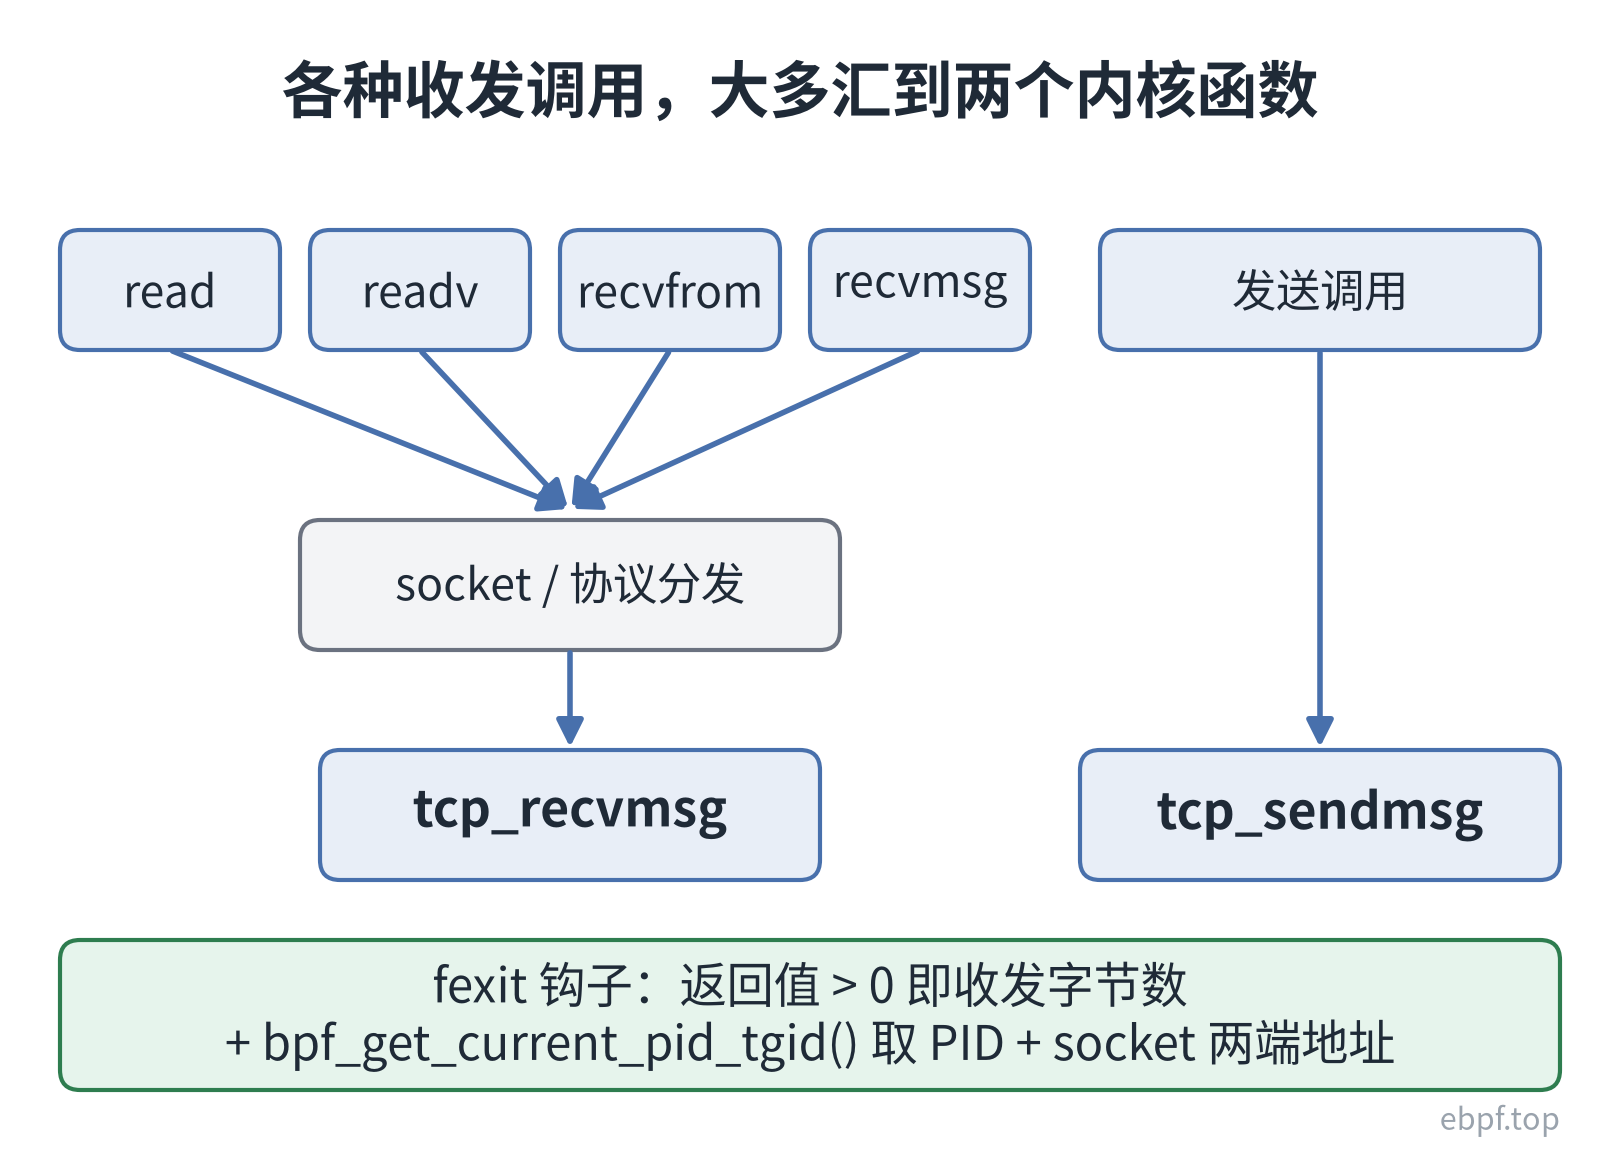
用户代码语言各异、库各不相同,但收 TCP 数据时,无论调用 read、readv、recvfrom 还是 recvmsg,经过内核的 socket 和协议分发后,大多会走到 tcp_recvmsg;发送方向对应 tcp_sendmsg。在这两个函数上挂 eBPF,就能看到绝大多数 TCP 流量,不管它来自哪个程序。
具体做法是在 fexit(函数返回时)挂钩子:返回值大于 0 时就是实际收发的字节数,再用 bpf_get_current_pid_tgid() 取出当前进程 PID,从 socket 结构里读出本端和对端地址。有了 PID,就能把流量对应到用户。
作者也专门说明了安全性:eBPF 程序加载前要经过 verifier 静态证明,包括内存访问受检查、寄存器已初始化、没有无界循环和递归、指针使用合法等。代价是有时得反复调整程序结构,才能让 verifier 通过。
3. 做法:在内核里按分钟聚合,而不是逐条上报
最直接的做法是每次调用都生成一条事件,送到用户态再进分析平台(HRT 用的是 Iceberg 表和 ClickHouse)。但他们的目标只是找出带宽的主要消耗者,并不需要每一次调用的明细。
于是改成在内核里聚合:用 BPF map 以 (pid, 本端 IP, 本端端口, 对端 IP, 对端端口) 为 key,累加收发字节。为了避免多核竞争,每个 CPU 维护独立的计数(per-CPU map)。每到整分钟,用户态把各 CPU 的计数读出来求和,再拼上进程元数据,归到用户、程序和工作流(由许多作业组成的大型运行),最后送进分析平台。
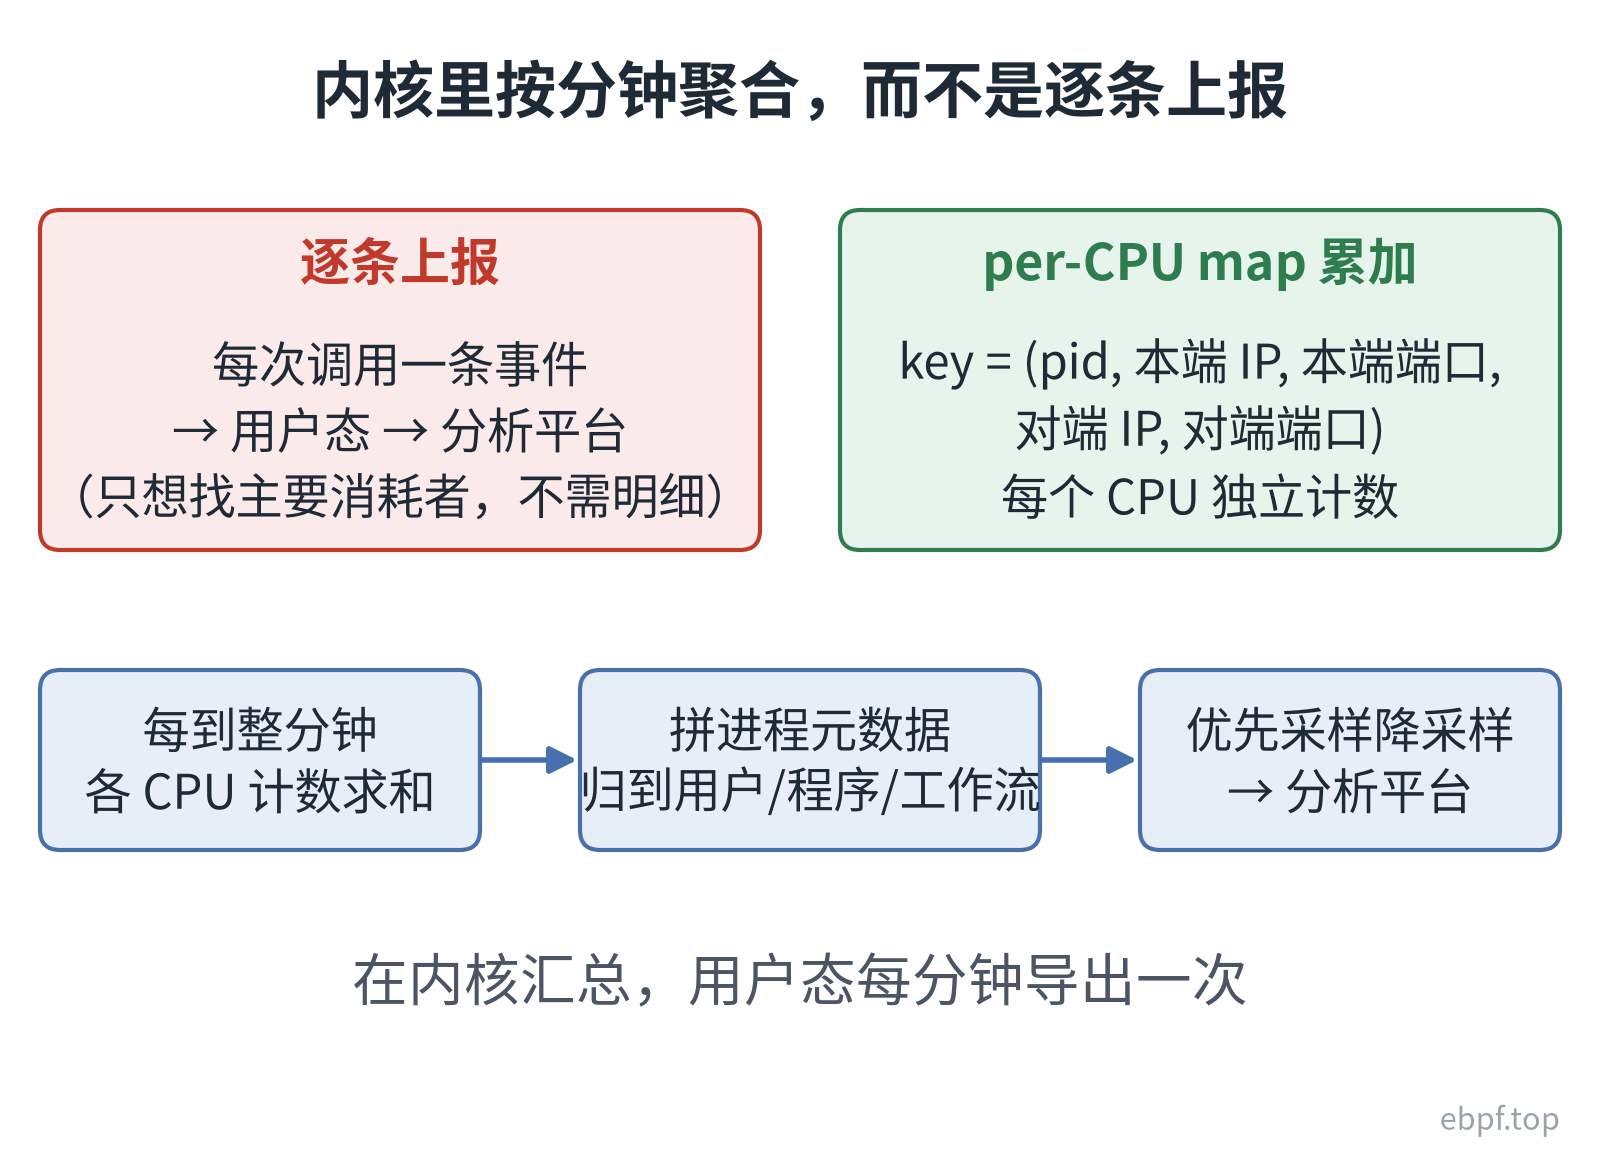
即便是分钟级汇总,数据量依然可观,他们又用一种优先采样(Priority Sampling)算法做了降采样。作者也提到,处理竞态和健康上报的代码在文中都省略了。
原文给出的代码是示意性质的,本号未在本地复现,生产环境使用前请自行验证。
4. 陷阱:NFS 让流量归属变成了 root
在整个集群部署钩子后,此前失踪的流量现身了。故障前的流量大多来自 eric:trade_simulation 工作流,它直接用 TCP socket,以前完全看不到。但新问题随之出现:
- 打满链路的那股流量,被记在
root用户和一个名为kworker/*xprtiod的程序名下。 - DupeDog 和 Cashy 的流量被记在
dupedog、cashy这些服务账号下,看不出真正发起请求的是谁。
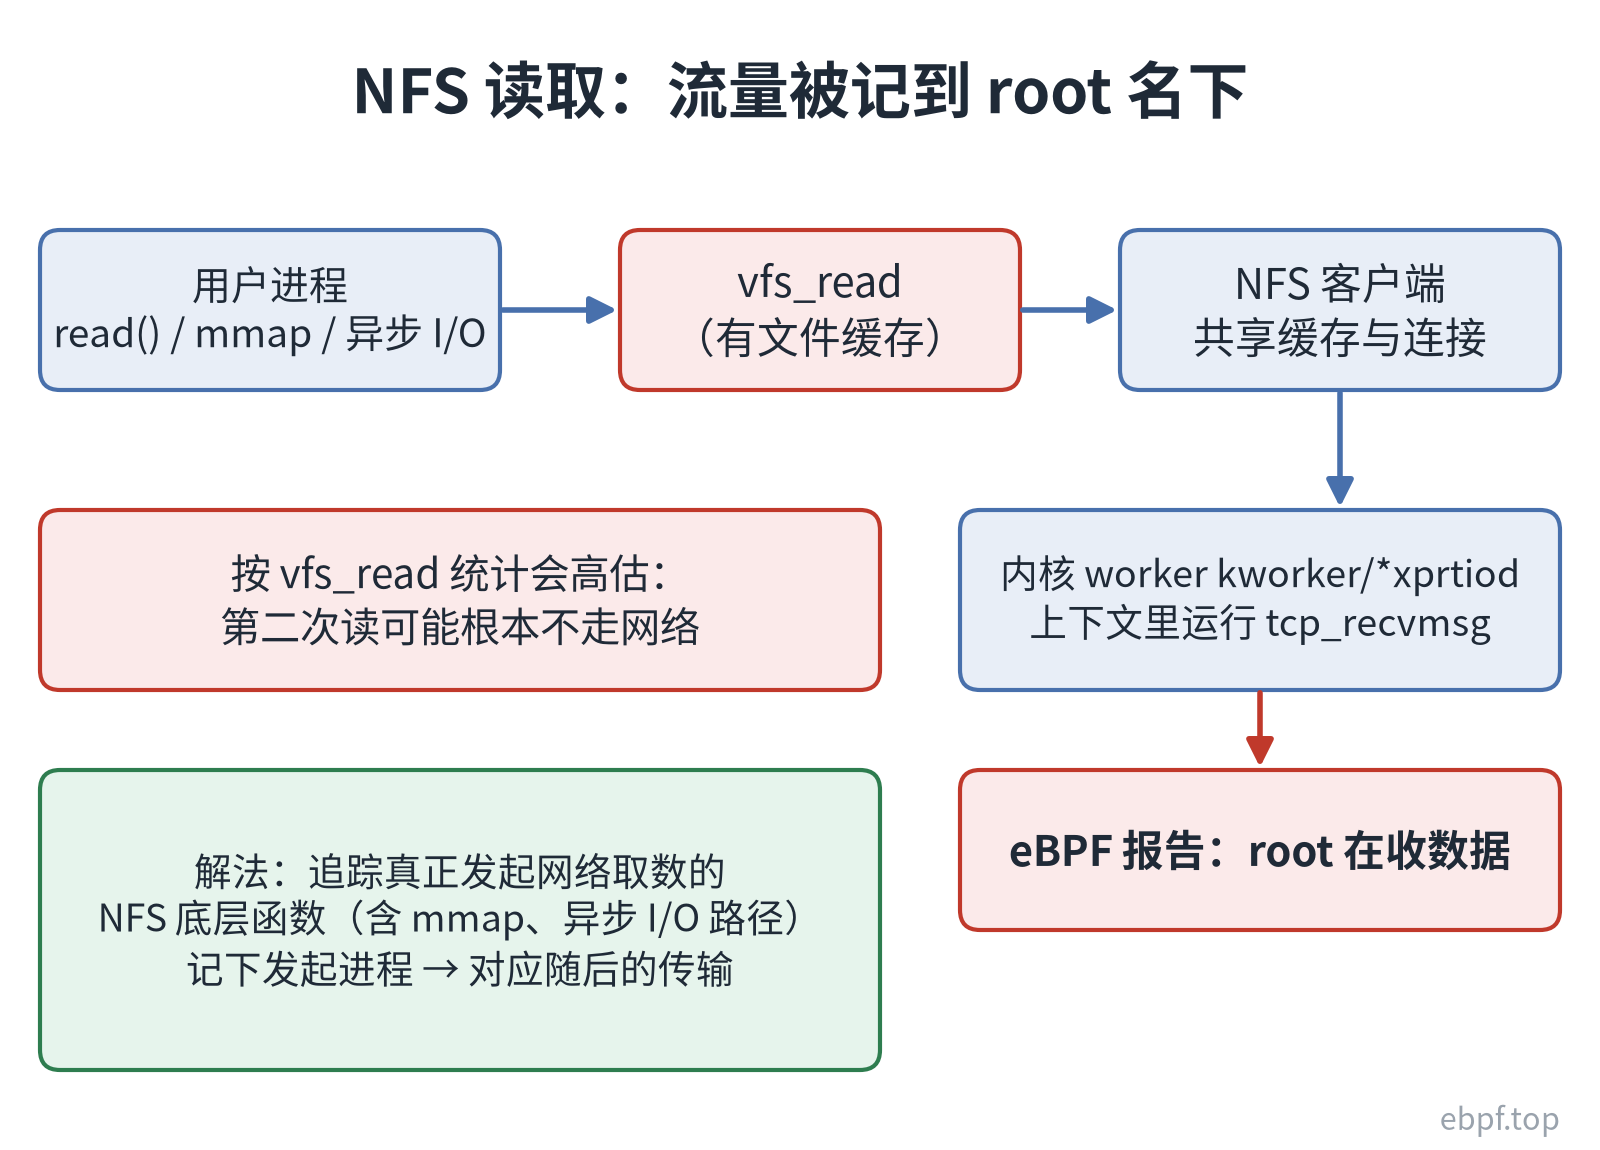
xprtiod 是 NFS 客户端做网络 I/O 用的内核工作队列。NFS 让程序像读本地文件一样读远程文件,读一次文件就可能触发一次网络传输。NFS 客户端会在多个进程之间共享缓存和连接,由内核 worker 代为收数据。所以即使是用户进程发起的读,tcp_recvmsg 也可能运行在内核 worker 的上下文里,eBPF 如实报告「root 在收数据」,却说不出是谁请求的。
他们的第一次尝试是挂 vfs_read,也就是进程调用 read() 时进入的内核函数。问题在于文件系统有缓存,同一份数据第二次读时可能根本不走网络,按 vfs_read 统计会高估网络流量。最后只能去追踪真正发起网络取数的 NFS 底层函数,包括经由内存映射(mmap)和异步 I/O 触发的路径:先记下是哪个进程发起了请求,再把它和随后的数据传输对应起来。作者直言这一步很痛苦,但做成了。
真相随之水落石出,是一次配置失误。芝加哥的上千个作业要读一个存放在纽约的大文件,正常做法是先把文件载入芝加哥的 Cashy 缓存,跨 WAN 只搬一次,再由本地缓存分发给各作业。这次却误把所有作业直接指向了纽约的源存储,同一个文件被跨区域传了上千遍。更糟的是,大家读的是同一个文件,纽约存储的本地缓存让磁盘 I/O 完全没有成为瓶颈,流量就这样畅通无阻地涌向 WAN。
5. 对账:三方数据各司其职,每个字节只算一次
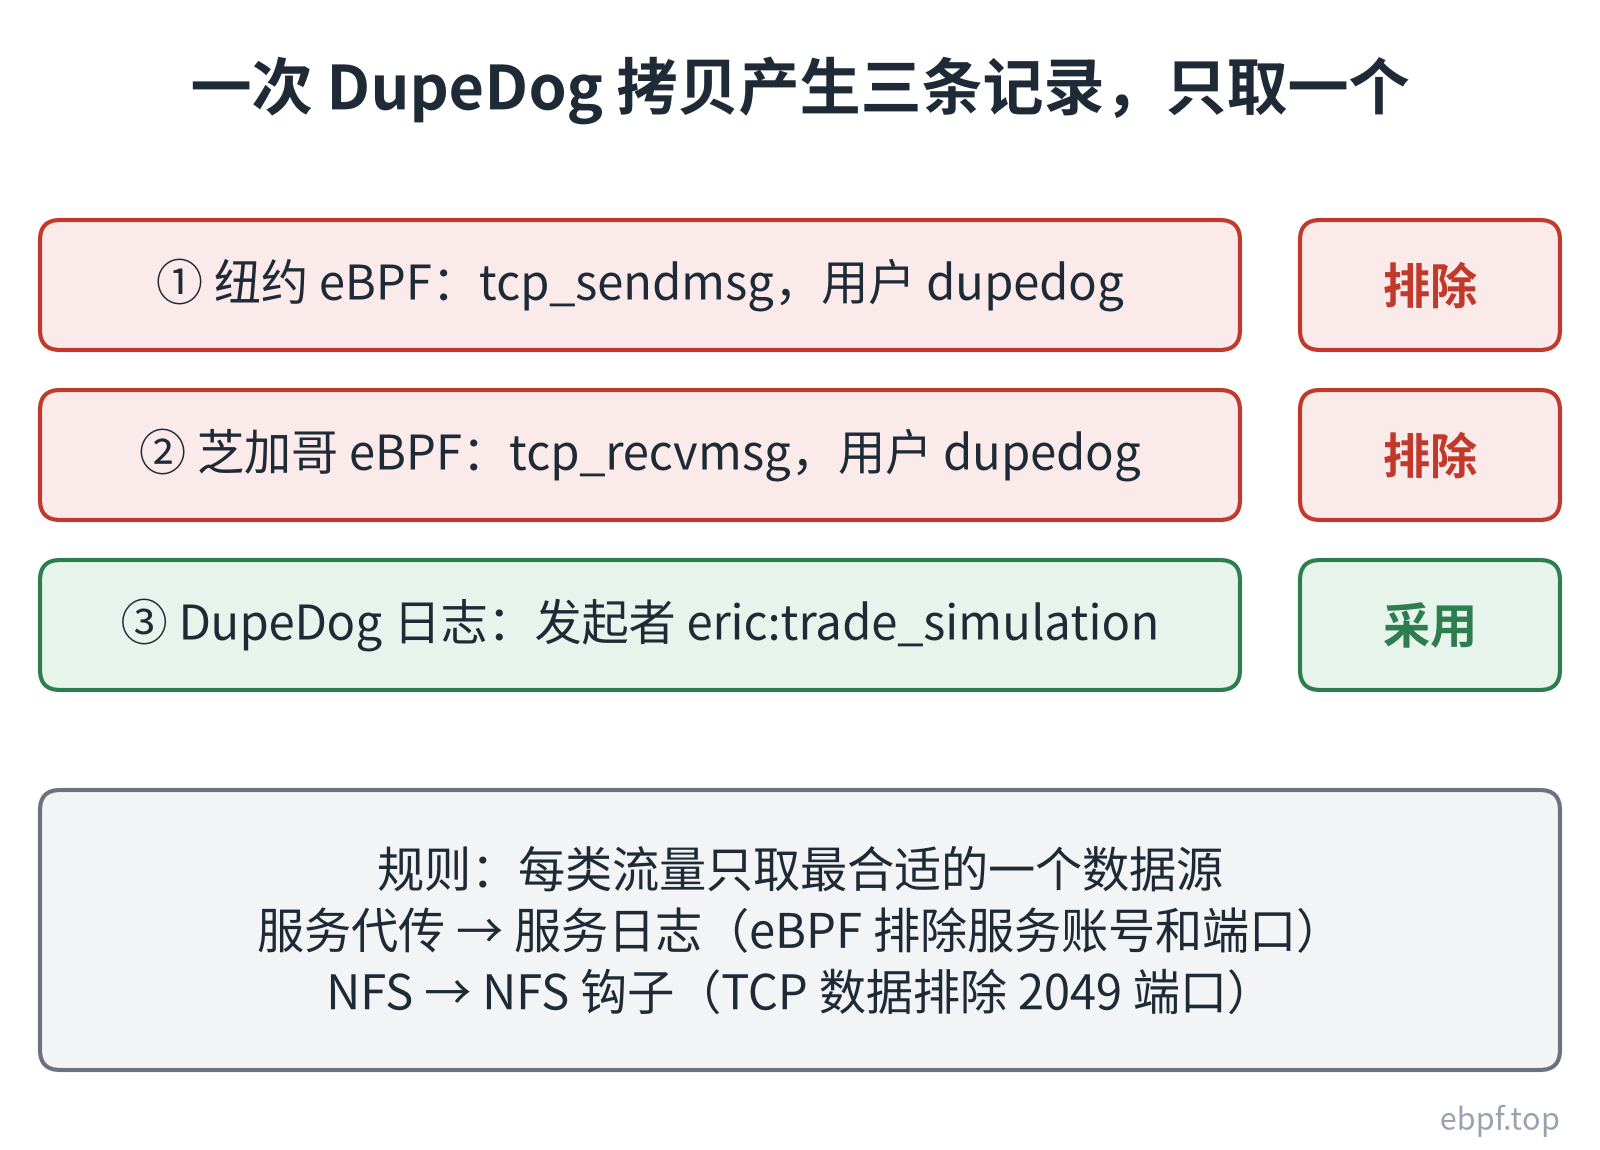
剩下的问题是服务代传的流量。当 eric:trade_simulation 请求 DupeDog 从纽约拷数据到芝加哥时,会产生三条记录:
- 纽约主机上,eBPF 看到一次
tcp_sendmsg,用户是dupedog。 - 芝加哥主机上,eBPF 看到一次
tcp_recvmsg,用户是dupedog。 - DupeDog 日志记下一次纽约到芝加哥的传输,发起者是
eric:trade_simulation。
简单相加会把同一份流量算三次。他们的规则是:每类流量只取最合适的一个数据源。DupeDog 这类服务的流量以服务日志为准,eBPF 数据中排除对应的服务账号和端口;NFS 流量由专门的 NFS 钩子统计,eBPF 的 TCP 数据中排除 2049 端口(NFS 默认端口)。
最终的数据由四个来源合成:
| 数据源 | 负责的部分 |
|---|---|
| eBPF socket 钩子 | tcp_recvmsg/tcp_sendmsg 的直连流量 |
| eBPF NFS 钩子 | NFS 引起的网络流量 |
| 服务日志 | DupeDog、Cashy 等服务代传的流量 |
| 交换机字节计数 | 独立的权威总量,用来校验 |
交换机计数是独立的权威总量,用来检验按用户归因的合计是否对得上。他们用热力图按站点追踪两者的吻合程度,绿色代表吻合,红色代表有遗漏。最近就靠它发现漏掉了存储节点之间的复制流量:连接两端都没跑 eBPF 记录程序,好在这部分有单独的复制指标可以补上。
6. 用途与限制:归因数据成了日常工具
这套数据现在是 HRT 的日常工具:网络突然过载时,能看到是哪些工作流造成的;把程序迁到新站点前,能看到它依赖哪些数据和服务,再决定要不要一起迁;还有自动化流程会限流制造麻烦的工作流,现在「打满 WAN」也被列入了限流条件。
几点限制值得留意:
- 覆盖依赖部署范围:连接两端都没跑 eBPF 记录程序的流量看不到,需要其他指标补位。
- NFS 关联成本高:要追到底层取数函数并处理 mmap、异步 I/O 等路径,作者自己也说很痛苦。
- 去重规则依赖对环境的了解:哪些端口、账号该排除,取决于你清楚有哪些服务、它们怎么记日志。
如果你关心的是数据包在协议栈里耗了多少时间,可以对照本号《数据包到底卡在哪?》:那篇关注时延,这篇关注字节的归属。
延伸阅读
- 原文作者:DavidDi
- 原文链接:https://www.ebpf.top/post/hrt-ebpf-wan-attribution/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议. 进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。
- 最后更新时间:2026-10-21 23:06:23.23517566 +0800 CST